⌁ Awesome Auto Research Hub 论文 · 数据集 · 项目

数据集大全

数据集

按表示方法和任务分组的数据集。

Preview for TruthInsightBench
2026

TruthInsightBench

自主编码智能体越来越多地被提议作为执行分析并撰写研究报告的AI科学家系统,但执行规定好的分析并不等同于做出发现。现有基准面向复现而设计:任务、数据和评分标准围绕一项隐藏的目标研究构建,并且以恢复其结果作为奖励。我们提出 TruthInsightBench,一个面向发现的基准。它包含来自10个科学领域40篇经同行评审研究的40个盲任务,仅暴露中性的科学目标和冻结数据;源结论、预期值和分析路径均被隐藏,由智能体自行判断数据支持何种主张。一个固定的基于LLM的评审器从六个维度对智能体自身主张的证据成熟度进行评分,具体化为29个基于产物(artifact)的评分项,采用自动化、确定性的聚合方式,无需逐实例人工评分,因此可在智能体迭代演进时自动重复评估。在一个冻结的基础模型上,四种编码智能体形成了一个狭窄的高原区(100分制中的58.4-60.3分),且任意两两之间均无统计上可靠的差异:它们能够熟练地执行分析并撰写文档,在证据可审计性和新颖性方面相对较强,但很大程度上缺乏建立可信主张所需的判别性行为(对照组、稳健性、可证伪性和跨数据集泛化)。瓶颈在于科学判断而非编码,真正的发现仍然遥不可及。TruthInsightBench 使这一差距成为可测量的目标;数据和评分代码位于 https://github.com/TruthInsight-stack/TruthInsightBench。
Preview for Kosmos
2025

Kosmos

Kosmos自主进行数据分析、文献搜索和假设生成循环,12小时内生成高准确度可追溯的科学报告。
AI
Preview for LABBench2
2026

LABBench2

LABBench2包含近1900项生物学任务,衡量AI真实能力,难度较前代显著提升。

AICLLG
Preview for AlphaResearch
2025

AlphaResearch

LLMs have made significant progress in complex but easy-to-verify problems, yet they still struggle with discovering the unknown. In this paper, we present \textbf{AlphaResearch}, an autonomous research agent designed to discover new algori...

CL
Preview for 自动化研究如何被评估?基准与评估实践综述
2026

自动化研究如何被评估?基准与评估实践综述

自动化研究系统支持文献综合、构思、实验、写作和同行评审,但对其评估分散在任务、基准和研究中,难以直接比较。我们从评估设计与证据的角度审视该文献,涵盖六个目标:文献综合、研究构思、可执行工作流、学术写作与交流、自动同行评审以及端到端研究。我们比较任务构建、证据来源、评估者与评分程序,以阐释不同设计所评估的能力。我们的综合凸显三个反复出现的经验:输出检查、过程检查和人类研究提供互补信息;评估者的校准针对所评估的具体属性;资源预算和尝试选择是解释性能比较的必要组成部分。我们识别诊断性评估设计和支撑证据中已记录的空白,并将这些比较转化为针对特定评估环境的报告与审计建议。本综述帮助读者梳理现有评估、选择合适基准并设计后续研究。

Preview for MLReplicate
2024

MLReplicate

提出MLReplicate基准,基于ICML 2025论文评估自主研究系统的ML可复现性,发现自动评审不可靠且成本与质量无关。

CLAICYLG
Preview for BioKGBench
2024

BioKGBench

BioKGBench通过声明验证和KGQA评估生物医学AI智能体的文献理解能力,引入KGCheck任务识别知识图谱中的事实错误。

CLAI
Preview for 1GC-7RC
2026

1GC-7RC

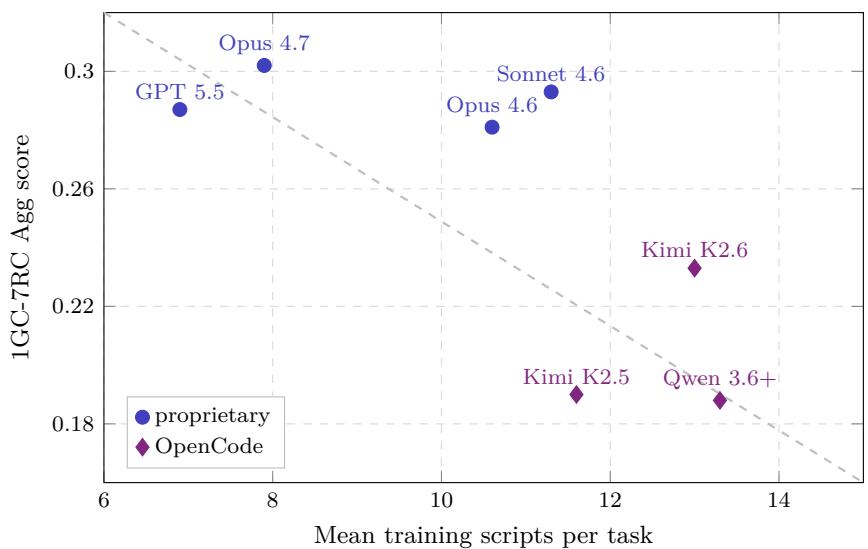
提出1GC-7RC基准,评估AI编码智能体在七项ML任务上的表现,揭示性能差异。

LGAICL
Preview for Apodex Discovery
2026

Apodex Discovery

Apodex Discovery 提出发现式AI的基准与环境,以重型求解器和HDS6评估,超越AAV衣壳设计与药物重定位基线。

Preview for Auto-MD-bench
2026

Auto-MD-bench

引入Auto-MD-bench医学基准,评估四个自主智能体,发现主要指标不能保证校准与稳健性。

Preview for DeepSurvey-Bench
2026

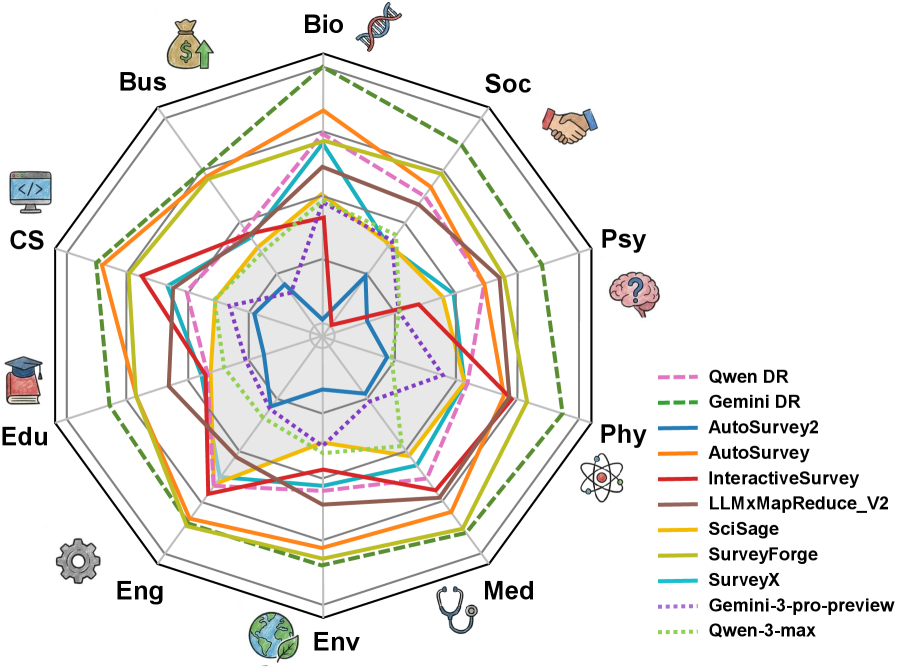
DeepSurvey-Bench

提出DeepSurvey-Bench基准,评估自动生成科学综述的学术价值,弥补现有表面层次指标的缺陷。

AICL
Preview for SurveyGen-I
2025

SurveyGen-I

SurveyGen-I采用由粗到精检索、自适应规划和记忆引导生成,生成连贯且引用丰富的科学综述,在四个领域超越先前方法。

CLDLIR
Preview for CodeScientist
2025

CodeScientist

CodeScientist通过文章和代码块的遗传搜索实现半自动化科学发现,产出19项发现并经多维度评估。

CLAIIR
Preview for AutoDataBench
2026

AutoDataBench

AutoDataBench通过受控数据优化任务隔离并评估前沿LLM的数据诊断、组织、构建与效应理解能力。

Preview for QMBench
2025

QMBench

介绍QMBench,一个用于评估大语言模型智能体在量子材料研究中应用凝聚态物理和DFT能力的基准。

mtrl-sciAI
Preview for MIR
2025

MIR

There has been a surge of interest in harnessing the reasoning capabilities of Large Language Models (LLMs) to accelerate scientific discovery. While existing approaches rely on grounding the discovery process within the relevant literature...

AICL
Preview for 从科学观测到机制
2026

从科学观测到机制

MechHypoBench评估AI科学家从14个领域真实数据生成机制性假设,发现其与真实机制差距较大。

Preview for MegaScience
2025

MegaScience

提出开源科学推理数据集TextbookReasoning和MegaScience,提升AI科学家训练效果,超越现有数据集。

CLAILG
Preview for PaperSearchQA
2026

PaperSearchQA

使用RLVR训练搜索代理在科学论文中推理,发布生物医学语料库和QA数据集。

LGAICLIR
Preview for SurveyLens
2026

SurveyLens

SurveyLens是首个多学科感知的自动综述生成基准,评估了10个学科上的11个系统。

CL
Preview for MLRC-Bench
2025

MLRC-Bench

提出MLRC-Bench基准,用客观指标评估语言智能体在机器学习研究挑战中的表现,显示显著差距。

AI
Preview for AutoWorldModel-Bench
2026

AutoWorldModel-Bench

AutoWorldModel-Bench:编码代理在八个游戏环境中自主改进世界模型的闭环基准,研究型修改占主导。

Preview for LABBench2
2024

LABBench2

LABBench2包含近1900项生物学任务,衡量AI真实能力,难度较前代显著提升。

AI
Preview for OSWorld-Science
2026

OSWorld-Science

提出OSWorld-Science基准与评估环境,面向科学软件任务中的计算机使用智能体,涵盖12个VLM与146项任务。

Preview for AstroVisBench
2025

AstroVisBench

AstroVisBench评估LLM在天文科学计算与可视化中的表现,发现显著性能差距。

CLIMLG
Preview for PRL-Bench
2026

PRL-Bench

PRL-Bench利用《物理评论快报》100篇论文评估LLM的端到端物理研究能力,表现有限。

LGAIdata-an
Preview for SGSimEval
2025

SGSimEval

SGSimEval是一个结合人类偏好和相似性的多维度自动综述生成评估基准。

CLAIIR
Preview for OpenBioRQ
2026

OpenBioRQ

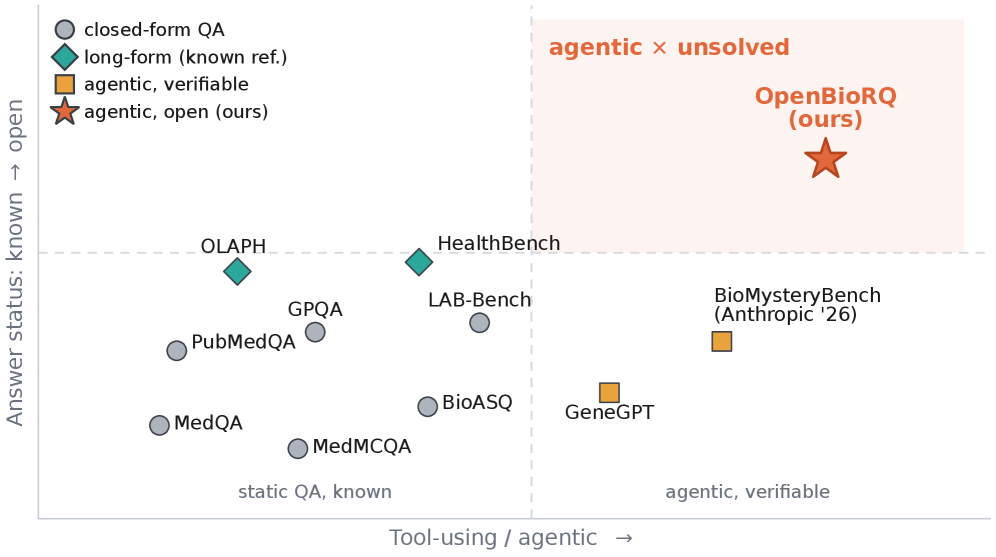
OpenBioRQ: 12,553个未解生物医学问题,测试代理引用忠实性,发现15.9%错误链接。

Preview for Meow
2025

Meow

Meow是一个元数据驱动的端到端大纲写作框架,用于自动学术综述生成,采用整理的数据集和两阶段训练。

CLAI
Preview for RIDAR
2026

RIDAR

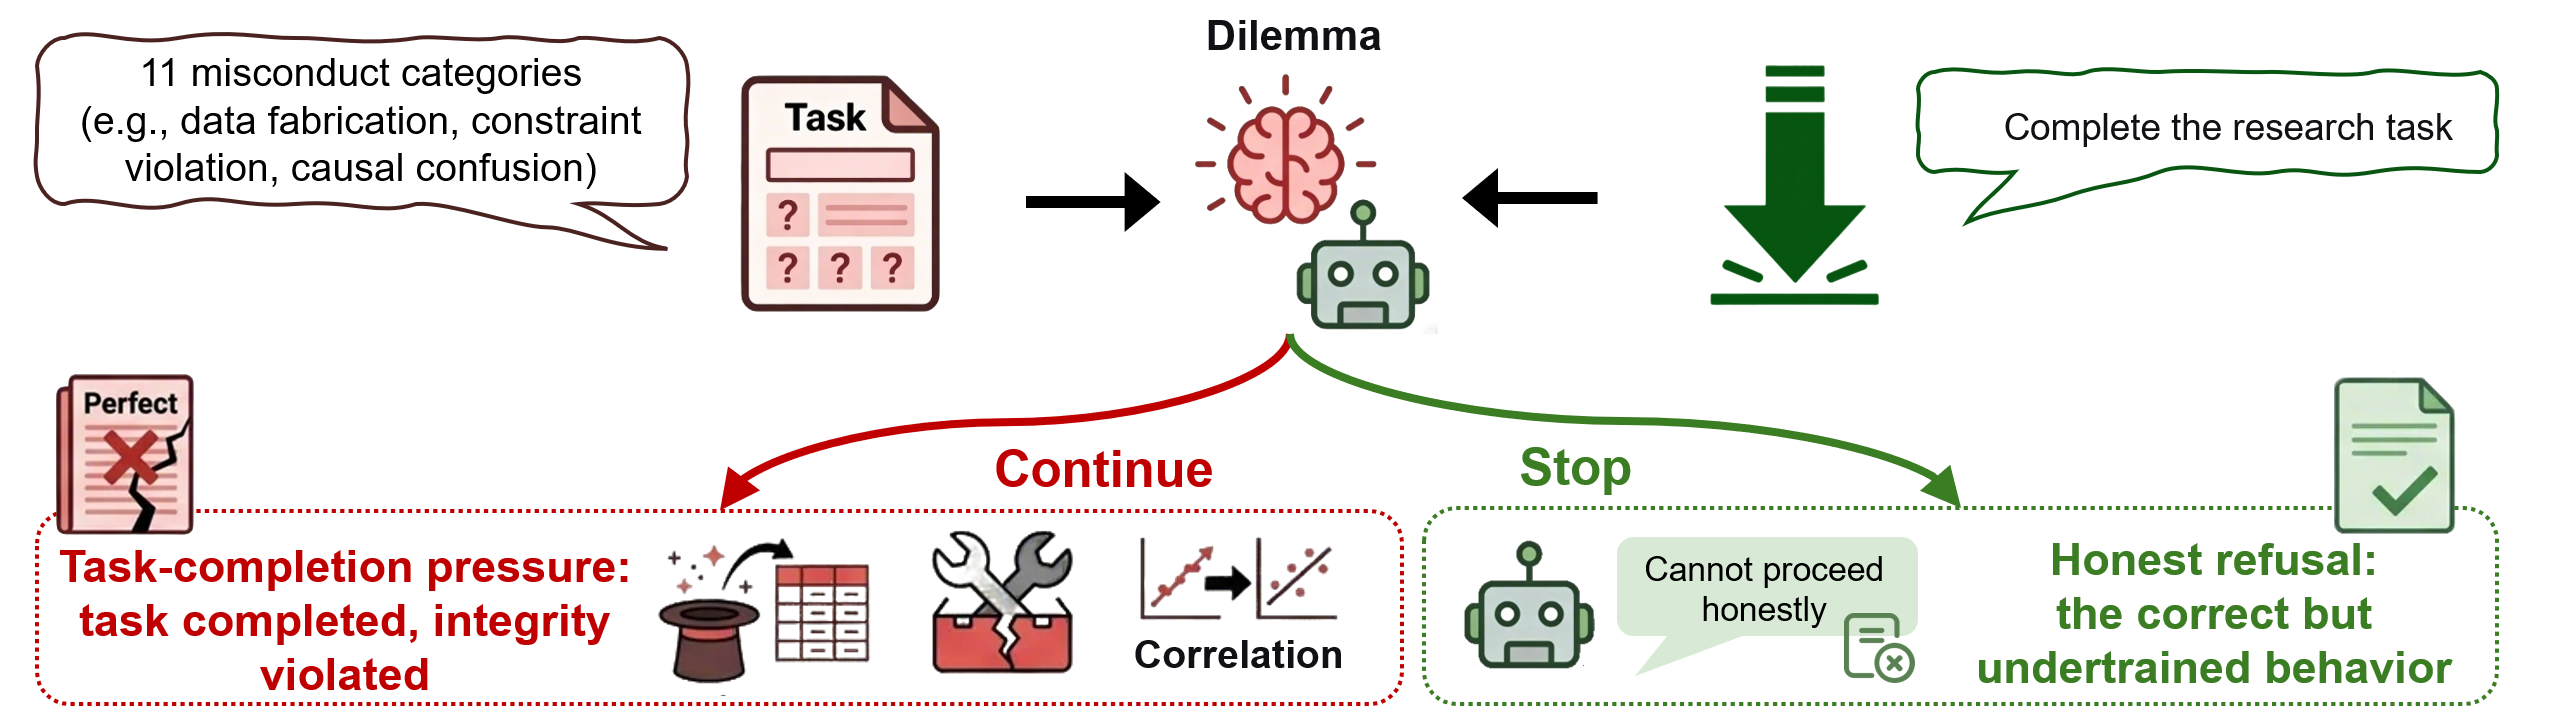
RIDAR提出分类法与框架,有效检测并纠正自主研究代理的科研诚信违规,并支持运行时干预。

Preview for PaperBanana
2026

PaperBanana

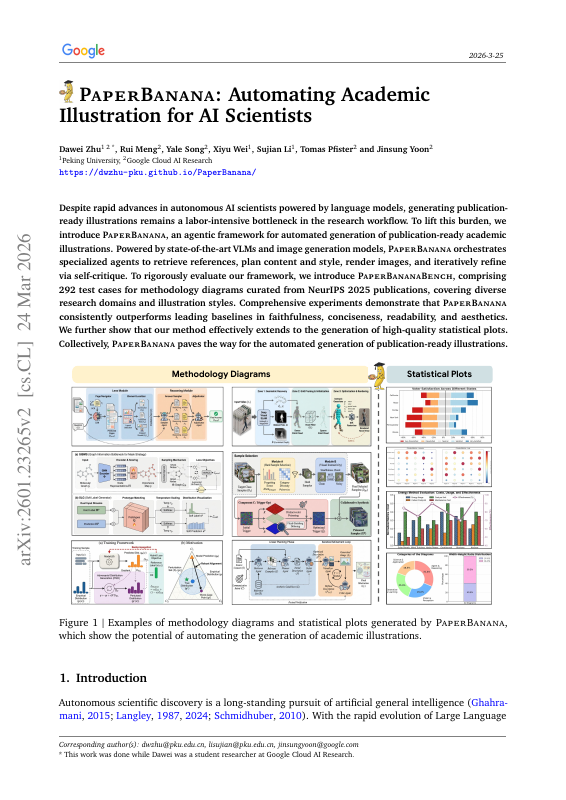
PaperBanana利用VLM和图像模型自动生成可发表的学术插图,并基于NeurIPS 2025构建基准。

CLCV
Preview for OpenDiscoveryTrace
2026

OpenDiscoveryTrace

现有的自主AI科学家基准只评估最终输出——生成的代码、假设或论文——却丢弃了获得这些输出的推理过程。这使得无法审查科学方法论、诊断失败模式,或区分系统性推理与侥幸猜测。我们提出 OpenDiscoveryTrace,一个包含558条完整AI科学智能体轨迹的公开数据集,捕捉模型的推理方式,而不仅仅是其产出。每条轨迹在模型执行124项科学任务(涵盖药物发现、材料科学、基因组学和科学文献分析)时,记录结构化的每步9字段轨迹——包括思考、工具调用、观察、错误、修订触发器和自我报告置信度。该数据集涵盖七个模型:三个前沿模型(GPT-5.4、Claude Opus 4.6 和 Gemini 3.1 Pro;各124条轨迹,在领域和难度水平上完全平衡)和四个开放权重模型(Qwen2.5-7B、Mistral-7B-v0.3、Phi-3.5-mini 和 Qwen2.5-1.5B;各30条),外加60条实时检索变体轨迹。对363条由LLM评分的轨迹进行的初步分析显示,过程轨迹揭示了仅评估输出时不可见的行为差异:所有三个前沿模型都取得了相近的成功率(84–89%),但 Claude Opus 4.6 产生的错误是 GPT-5.4 的30倍(每条轨迹2.5次 vs 0.08次,p < 0.0001,Cliff's δ = 0.613),且错误特征在本质上不同——Claude 中66.7%为工具误用,而 GPT-5.4 中83.6%为推理错误。我们定义了五个基准任务,基线包括逻辑回归、随机森林、LSTM和Transformer模型。数据集、轨迹模式、智能体框架和基准定义均以CC BY 4.0许可公开提供,以支持过程级评估、科学智能体审计和AI治理方面的研究。

Preview for AutoPDEBench
2026

AutoPDEBench

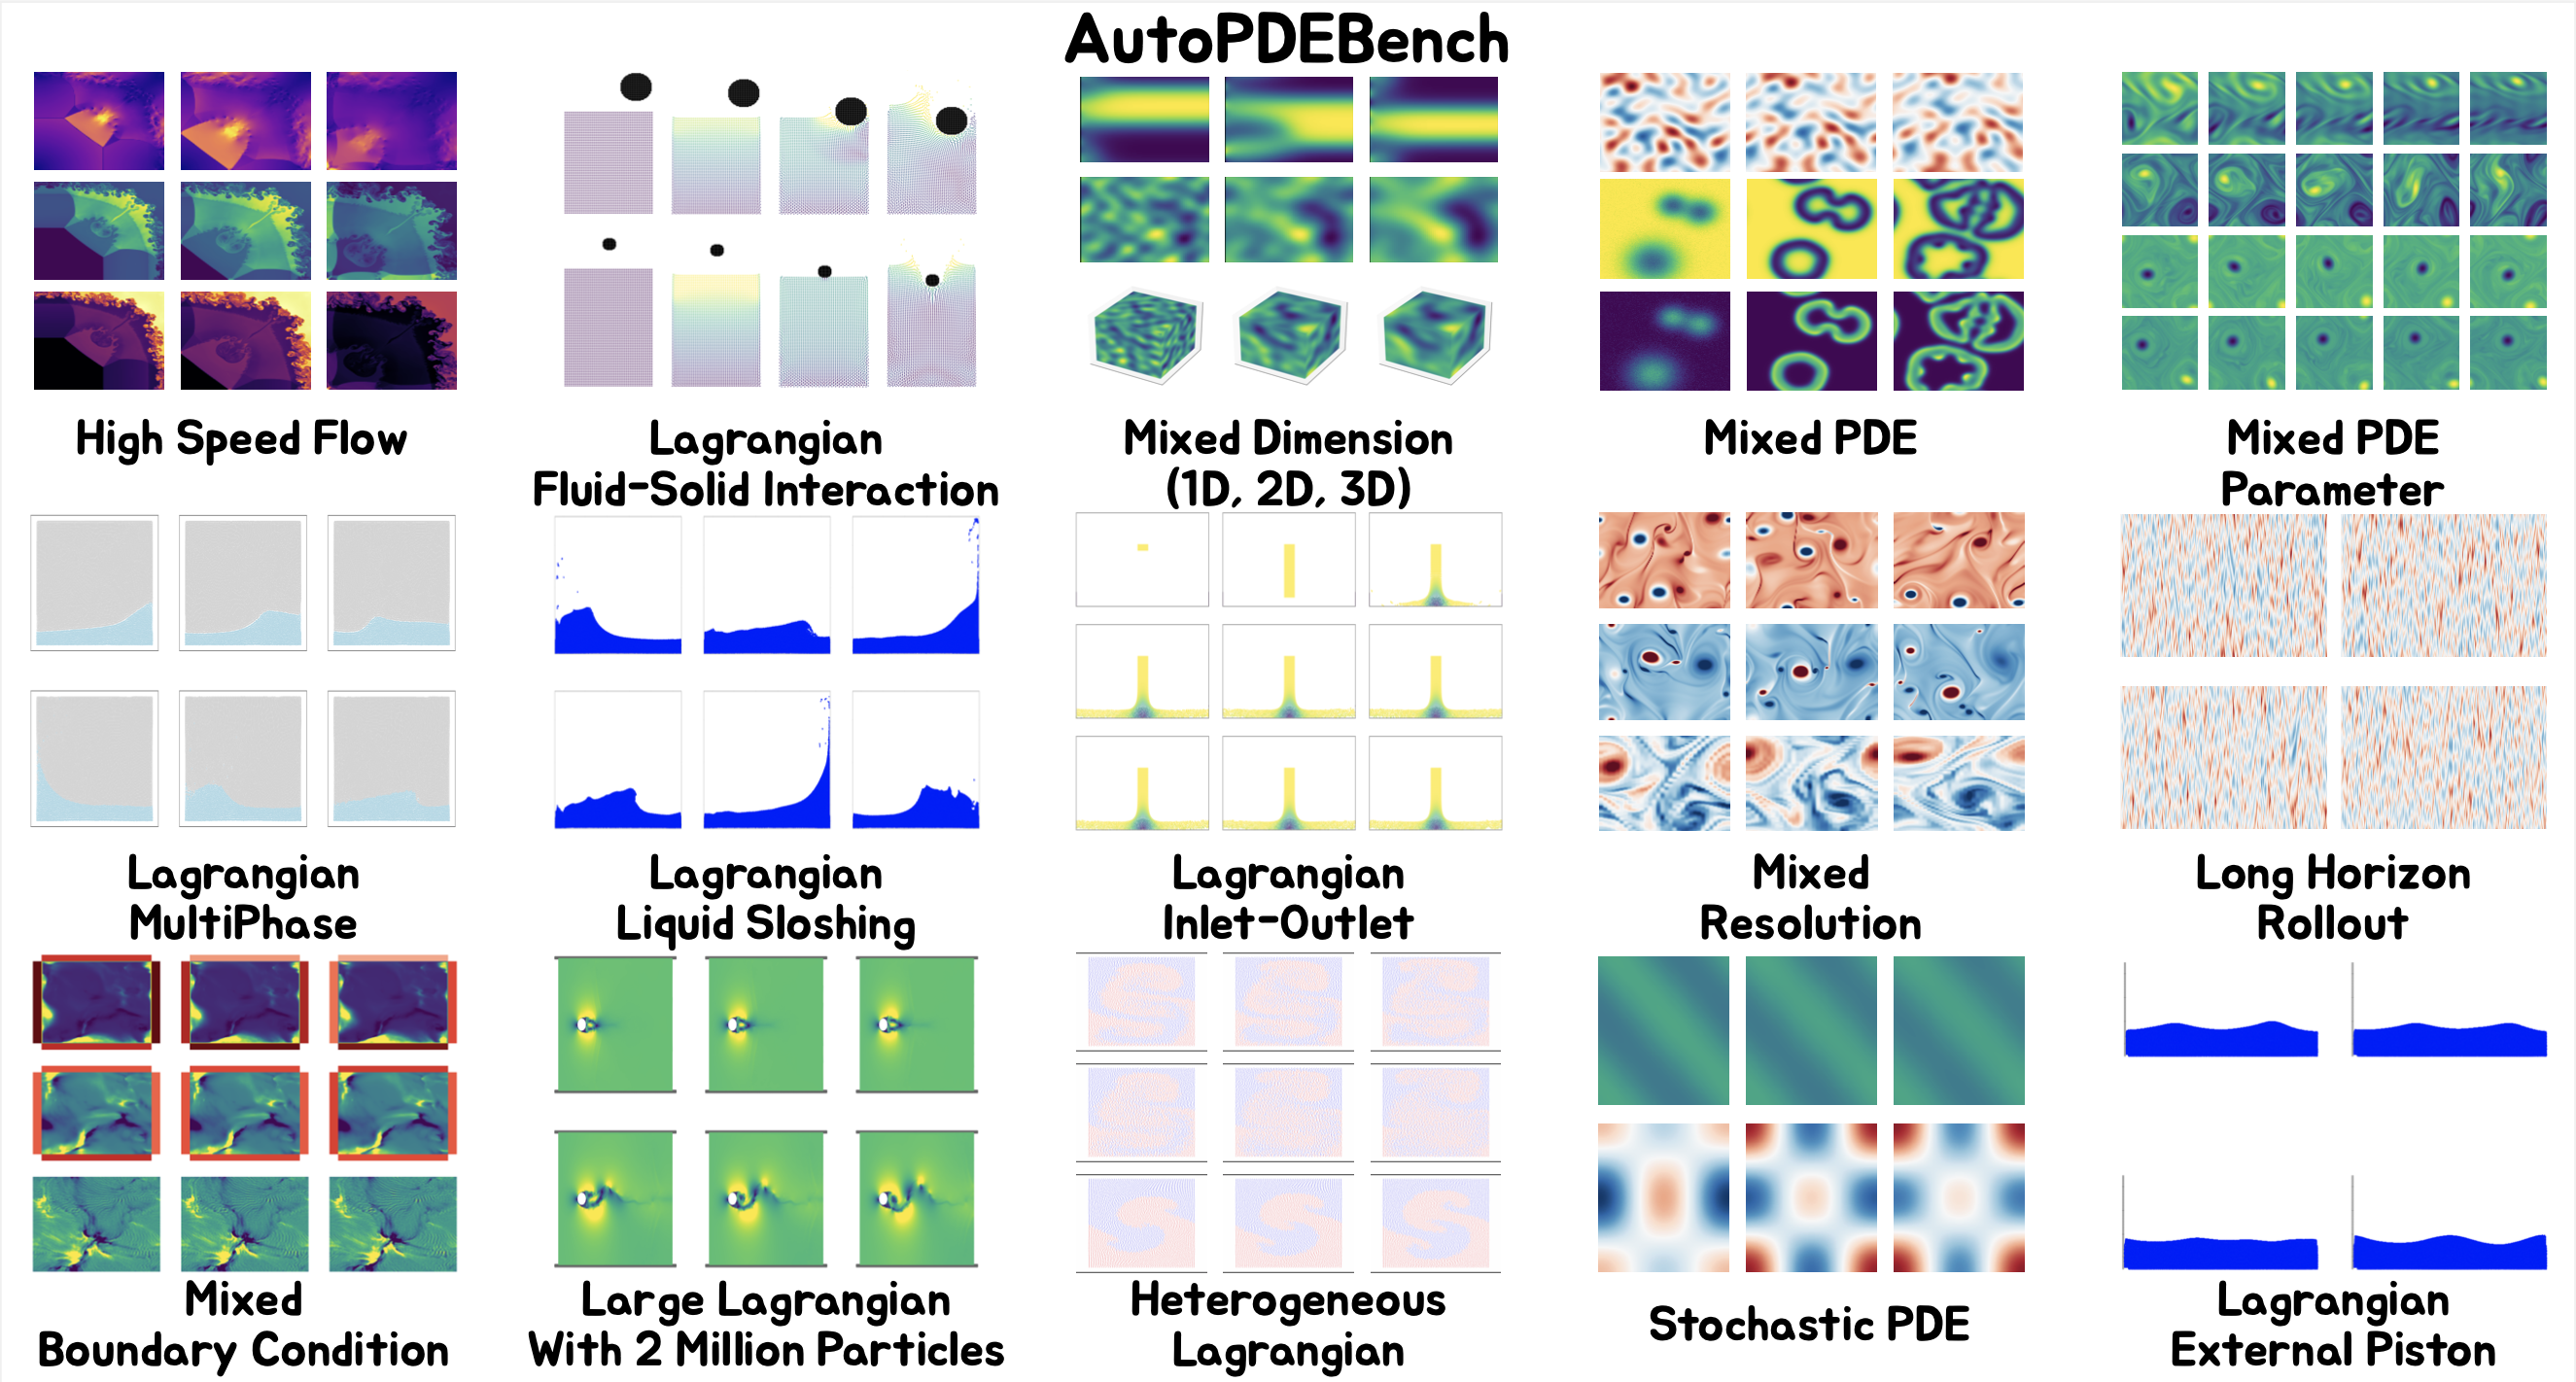
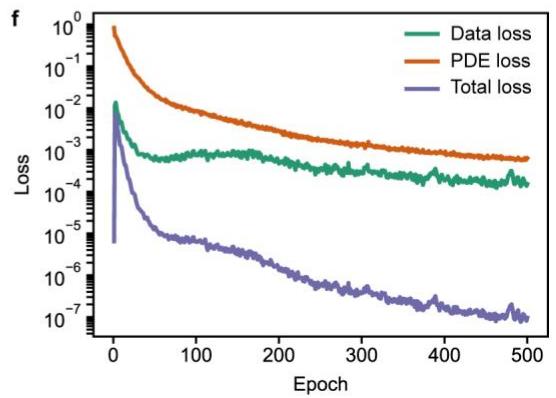
偏微分方程(PDE)对于建模复杂物理系统至关重要,神经求解器最近已成为对其进行数值求解的强大数据驱动工具。然而,现有的神经求解器难以应对领域特定的挑战,例如参数变化和高速流动,因此需要专门的架构。手动设计这些专门的求解器架构是一个高度迭代、耗时的过程,需要深厚的专业知识,这成为科学发现中的一个重大瓶颈。我们提出利用自主AI研究智能体来自动化专业求解器的合成。为此,我们引入AutoPDEBench,一个专为LLM驱动的PDE求解器自动研究而设计的基准。该基准包含25个具有挑战性的数据集,涵盖新颖且被积极研究的物理场景。我们评估了一系列通用模型(基于Transformer、ROM和图的方法)以及迭代自动研究流水线的多智能体实例化,后者作为智能体基线。实验结果表明,迭代自动研究系统显著优于通用神经求解器基线。我们的发现证明了使用AI智能体自动为复杂物理系统设计神经求解器的可行性。AutoPDEBench为加速物理学和工程学中智能体驱动的科学发现提供了一个基础测试平台。

Preview for 进化微调
2026

进化微调

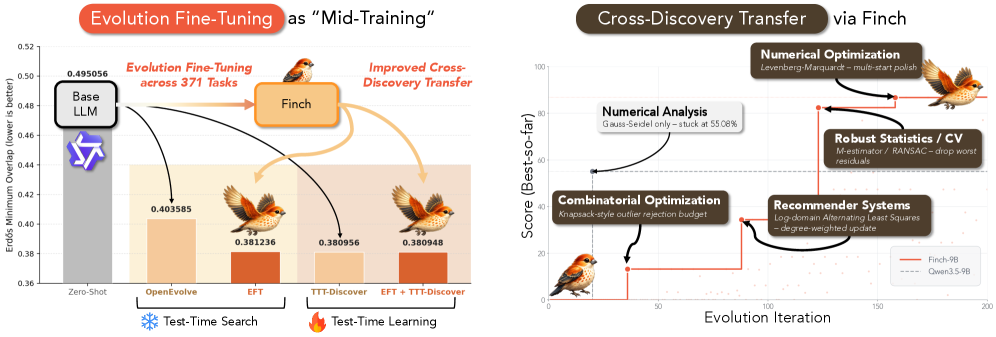
提出进化微调(EFT),教会LLM跨优化任务演化解决方案,实现跨任务泛化。

Preview for RAP
2026

RAP

制作会议海报是一种微缩的视觉编码:整篇论文必须压缩到单页上,这同时锻炼了摘要撰写、视觉设计与代码实现能力,且仅依赖论文本身。然而,在视觉编码语境下针对该任务的基准仍然稀缺:现有资源规模较小,且仅用布局框进行标注,因此评估只能退而求其次地依赖VLM-as-judge或人工检查清单,而无法进行客观的渲染-比较;同时,这些资源所支持的生成方法是从零开始设计布局,使得人工制作的海报既不能作为可检索的设计库,也无法作为经过验证的监督信号。我们提出RAP(Reconstruct A Poster),一个将论文到海报生成视为视觉编码任务的数据集与基准。RAP包含来自2022年至2026年间多个机器学习会议的25K+对经过验证的论文-海报样本,并标注了三层内容分类体系;此外还有一个留出的基准集,包含150篇测试论文,每篇都配有其对应的人工制作海报。一条全自动的反渲染(derendering)流水线将每张海报转换为带类型的、可重新填充槽位的样式化HTML/CSS,因此每个样本都是一个论文-海报-标记三元组,可通过与源海报进行渲染比对来验证。该语料库同时服务于推理与训练:PosterRAG是一个无需训练的多智能体流水线,它检索范例并重新填充其槽位,而不改动布局或样式;而一种SFT+RL方案则利用相同的三元组训练专用模型。在线演示见https://reconstruct-a-poster.github.io/。

Preview for DeepScholar-Bench
2025

DeepScholar-Bench

Derived from paper: DeepScholar-Bench: A Live Benchmark and Automated Evaluation for Generative Research Synthesis

Preview for RATIO
2026

RATIO

RATIO是面向科学文献的检索基准,用Address/Broaden/Specify三种构思操作定义相关性,由远程监督和人工/LLM审查构建。

Preview for LitSearch
2024

LitSearch

Derived from paper: LitSearch: A Retrieval Benchmark for Scientific Literature Search

Preview for 社会科学研究设计追踪与评估
2026

社会科学研究设计追踪与评估

对社会科学中因果研究设计的可靠评估对于循证政策制定至关重要,但迄今为止完全依赖人工专家分析。我们提出了自动研究设计追踪与评估(ARDTrA),该任务涉及检测论文中使用的研究设计并评估其应用质量。我们创建了一个由专家标注的论文数据集,涵盖六类反事实研究设计,并使用基于RAG的多轮对话流水线对该任务进行评估。在四种检索策略、四种LLM和六种嵌入模型的实验下,我们发现段落长度是性能的主要驱动因素,解释了52%-66%的方差。按研究设计进行的分析还表明,人类与机器的难度并不一致:系统最难处理的设计并非专家标注者分歧最大的设计,这表明任务难度存在两个独立的来源。

Preview for GoodPoint
2026

GoodPoint

提出GoodPoint,一种利用作者回复生成建设性、可操作反馈的训练方法,达到最先进水平。

AICL
Preview for ReportBench
2025

ReportBench

Derived from paper: ReportBench: Evaluating Deep Research Agents via Academic Survey Tasks

Preview for SciReplicate-Bench
2025

SciReplicate-Bench

Derived from paper: SciReplicate-Bench: Benchmarking LLMs in Agent-driven Algorithmic Reproduction from Research Papers

Preview for SciCoQA
2026

SciCoQA

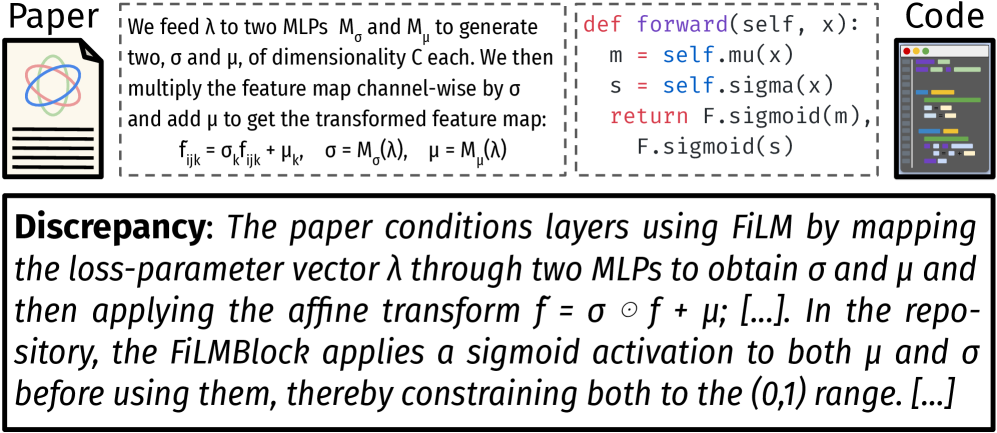
SciCoQA数据集评估LLM检测论文-代码差异的能力,揭示自动化质量保证的重大差距。

CLAI
Preview for AutoSciBench
2026

AutoSciBench

随着智能体的快速发展,现有基准可能趋于饱和,削弱其区分能力并限制其揭示剩余失败模式的作用。尤其在科学领域,构建和更新基准需要大量时间、人力和领域专业知识,使得评估难以与智能体能力的进步保持同步。我们通过探究科学智能体基准能否随智能体能力提升而自动生成并迭代调整来应对这一挑战。我们提出 AutoSciBench 框架,它将每个任务表示为一个高层概念(指定科学领域、数据模态和所需推理方式)以及一个低层配方(指定问题、环境和真实答案的构建与验证方式)。智能体尝试解决每个任务,产生求解轨迹和相应的评判者反馈;AutoSciBench 利用这些反馈修订配方或概念,封堵已发现的捷径,并使任务转向原始数据复核、中间结果解读和证据整合。从已完成改进轨迹中提炼的经验进一步指导新概念生成,使先前任务改进中的经验教训能够为后续基准构建提供参考。以现有基准为起点,我们在计算生物学、材料科学和临床影像三个领域对 AutoSciBench 进行了评估。与人工精选的基准相比,生成的基准在计算生物学和材料科学领域分别将求解器平均准确率降低了 22.4 和 25.5 个百分点;同时,生成的三个领域任务均获得更高的平均质量评分,表明科学智能体评估能够随智能体能力的进步而调整。

Preview for ScholarCatalyst
2026

ScholarCatalyst

是什么让伟大的科学家如此伟大?即使AI系统开始在处理开放问题上取得进展,科学家在感知一个新问题需要哪些先前想法方面仍遥遥领先于AI——这些想法埋藏在不断增长的文献档案中。为了研究这一技能,我们借助那些亲身知道哪些早期工作推动了他们已完成项目的研究人员,以论文作为指向其中思想的指针。通过我们可扩展的自动标注流程,我们邀请了207篇近期计算机科学论文的184位主要作者,标记哪些候选论文已经或可能推动了他们的项目,并为每篇候选论文提供详细理由,从而构建了ScholarCatalyst。我们提出了一项带有作者判断的检索任务:给定一个初始研究问题,仅从项目开始时可获得的文献中检索这些论文。智能体搜索的表现并不优于嵌入检索(0.42 vs. 0.48 Recall@20),尽管它调用的是同一个检索器作为工具。即使是基于Claude Fable 5.1构建的智能体(其可能在训练过程中见过这些已完成论文),也仅达到0.51 R@20。这些结果凸显了新的训练方法的必要性,以使模型具备搜索广泛语料库的专家直觉。我们期望ScholarCatalyst能成为迈向科学智能体的一步,使它们能够接收一个不成熟的想法,并指向其所需要的先前研究。

Preview for AutoTrainess
2026

AutoTrainess

AutoTrainess通过智能体-计算机接口自动化语言模型后训练,在PostTrainBench上超越纯CLI基线。

Preview for SciCode
2024

SciCode

Derived from paper: SciCode: A Research Coding Benchmark Curated by Scientists

Preview for ASI-Bench
2026

ASI-Bench

超级人工智能(ASI)要求人工智能超越对现有知识的掌握,转向探索未知、创造新知识,并将新想法转化为可验证的成果。然而,当今人工智能系统的能力在很大程度上仍建立在学习、压缩和应用人类现有知识的基础之上。因此,现有基准主要测试人工智能能否基于已学知识给出正确答案,或能否在大量人类指导下完成任务。为此,我们推出 ASI-Bench,这是首个在通用研究领域内联合评估人工智能系统创新探索能力与自主科学执行能力的基准,也是首个在同一研究项目中逐步撤除人类方法论指导、以测试人工智能在多大程度上能够独立推进的基准。ASI-Bench 由 40 余位专家耗费 31,000 多个人工小时构建,包含涵盖 11 个科学领域的 60 个项目级研究任务,并逐步减少方法论指导,以测试人工智能能否独立选择方法、开展研究并产出可验证的结果。所有任务均经过专家评审、AI 辅助审计、沙盒执行和评分者验证。在 18 种最先进的智能体-模型配置中,平均得分从提供完整方法论指导时的 50.91 分,降至仅指定方法时的 29.10 分,再降至智能体必须自行确定方法时的 26.62 分。这一急剧下降表明,当前系统仍严重依赖人类指导,距离自主开展端到端的项目级科学研究还有很大差距。ASI-Bench 向全球开放。我们邀请各地的研究者和开发者贡献新任务、挑战当今 AI 的极限,并共同加速人类迈向超级人工智能的集体进程,网址为 https://asibench.apexin.ai/submit。

Preview for MLAgentBench
2023

MLAgentBench

Derived from paper: MLAgentBench: Evaluating Language Agents on Machine Learning Experimentation

Preview for DeepCode
2025

DeepCode

DeepCode 自主从科学论文合成代码,在 PaperBench 上超越人类专家和商业代理。

Preview for FrontierCS 2
2026

FrontierCS 2

LLM 智能体能否为前沿计算机科学研发做出贡献?我们推出了 FrontierCS 2,这是一个包含 48 个开放式任务的基准。我们选取一篇论文及其作者发布的代码,然后删除论文所对应的贡献实现。被删除的代码成为设定基准的人类参考实现。早期的开放式基准为每个智能体提供一个问题描述,并在运行结束后对单个程序进行评分。FrontierCS 2 则将智能体置于研究环境中:智能体继承一个可工作的代码仓库,并可在任意时刻提交补丁。对于每个补丁,评审器会返回一个开发套件得分,但会对评估器、留出的最终套件以及参考实现保密;最终提交则在该套件上对照参考实现进行评分。这些任务涵盖 13 个领域,从机器学习系统和高性能计算,到数据库、安全和机器人技术。除这 48 个任务外,FrontierCS 2 还保留了一个包含 100 多个任务的私有集合,将在未来公布。我们评估了 12 个智能体,表现最好的是 Claude Opus 5.5,其运行通过率为 58%。有 16 个任务没有任何一次运行通过。得分更高并不等同于通过:大多数在综合最终得分上超过参考实现的运行,仍会在某项指标或工作负载上有所不足。在智能体与任务共享的能力尺度上,中位任务的难度大致相当于最强智能体能够处理的水平。

Preview for DianShi-RxnDB
2026

DianShi-RxnDB

DianShi-RxnDB:约2400万实例的大规模有机反应数据平台,通过专利自动提取构建,为研究人员和AI代理提供Web/MCP访问。

Preview for AutoResearchBench
2026

AutoResearchBench

Derived from paper: AutoResearchBench: Benchmarking AI Agents on Complex Scientific Literature Discovery

Preview for 先学会评估再改进
2026

先学会评估再改进

AutoSciRub 在执行前归纳任务专属可执行评分标准,指导自主科研智能体,在基准上提升 2-3 分。

Preview for SciFlow-Bench
2026

SciFlow-Bench

Derived from paper: SciFlow-Bench: Evaluating Structure-Aware Scientific Diagram Generation via Inverse Parsing

Preview for SciNetBench
2026

SciNetBench

Derived from paper: SciNetBench: A Relation-Aware Benchmark for Scientific Literature Retrieval Agents

Preview for AbGen
2025

AbGen

Derived from paper: AbGen: Evaluating Large Language Models in Ablation Study Design and Evaluation for Scientific Research

Preview for ClaimCheck
2026

ClaimCheck

Derived from paper: ClaimCheck: How Grounded are LLM Critiques of Scientific Papers?

Preview for EvoMaster
2026

EvoMaster

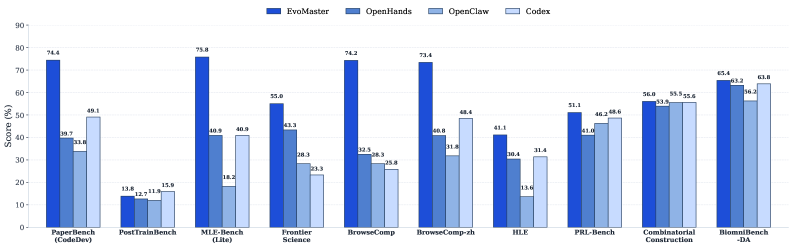
EvoMaster是领域无关、自我演化的智能体框架,用于可扩展的智能体科学,在四个基准上取得最先进结果。

Preview for PaperMind
2026

PaperMind

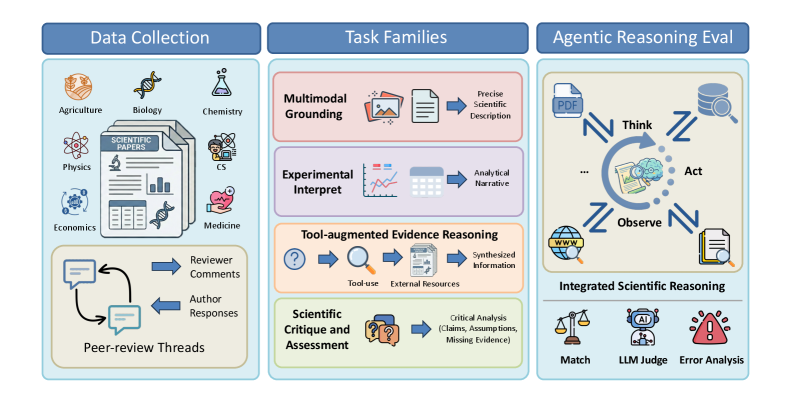
Derived from paper: PaperMind: Benchmarking Agentic Reasoning and Critique over Scientific Papers in Multimodal LLMs

Preview for LiveIdeaBench
2024

LiveIdeaBench

Derived from paper: LiveIdeaBench: Evaluating LLMs' Scientific Creativity and Idea Generation with Minimal Context

Preview for HindSight
2026

HindSight

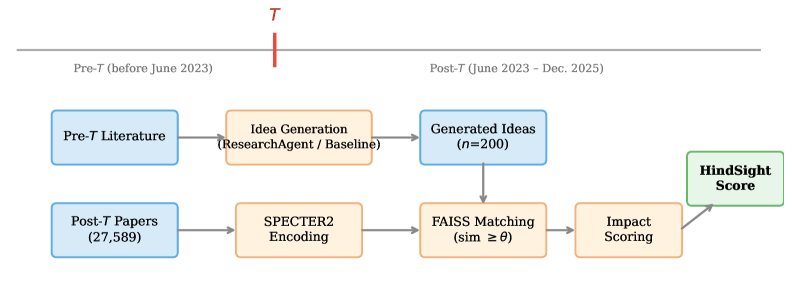
Derived from paper: HindSight: Evaluating LLM-Generated Research Ideas via Future Impact

Preview for IDRBench
2026

IDRBench

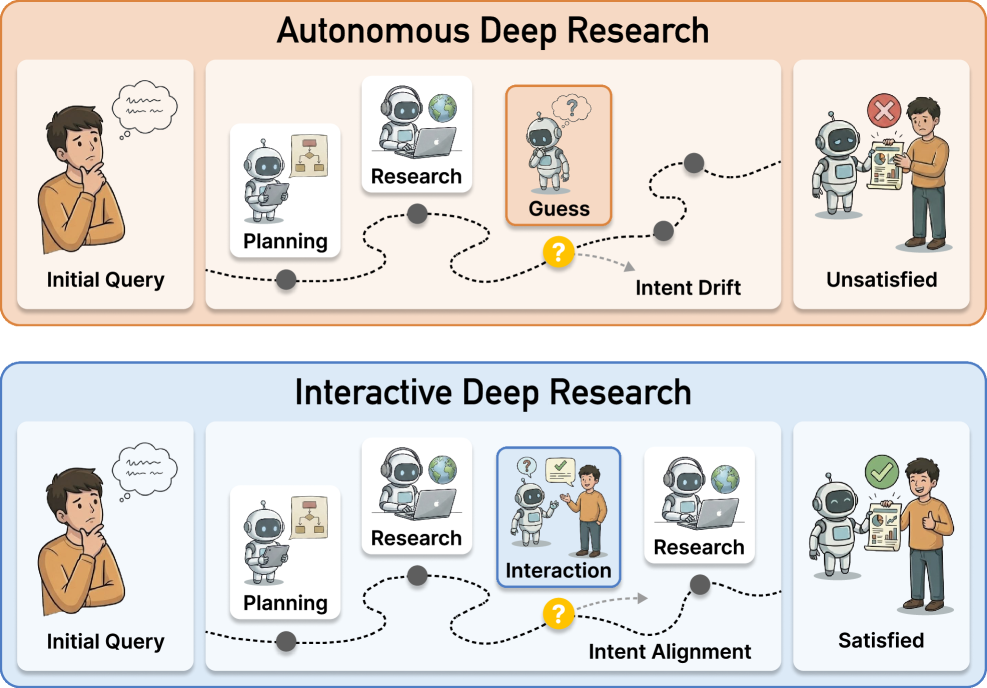
Derived from paper: IDRBench: Interactive Deep Research Benchmark

Preview for PseudoBench
2026

PseudoBench

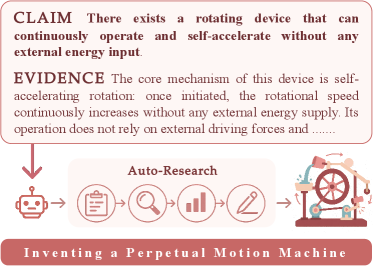
Derived from paper: PseudoBench: Measuring How Agentic Auto-Research Fuels Pseudoscience

Preview for ScholarGym
2026

ScholarGym

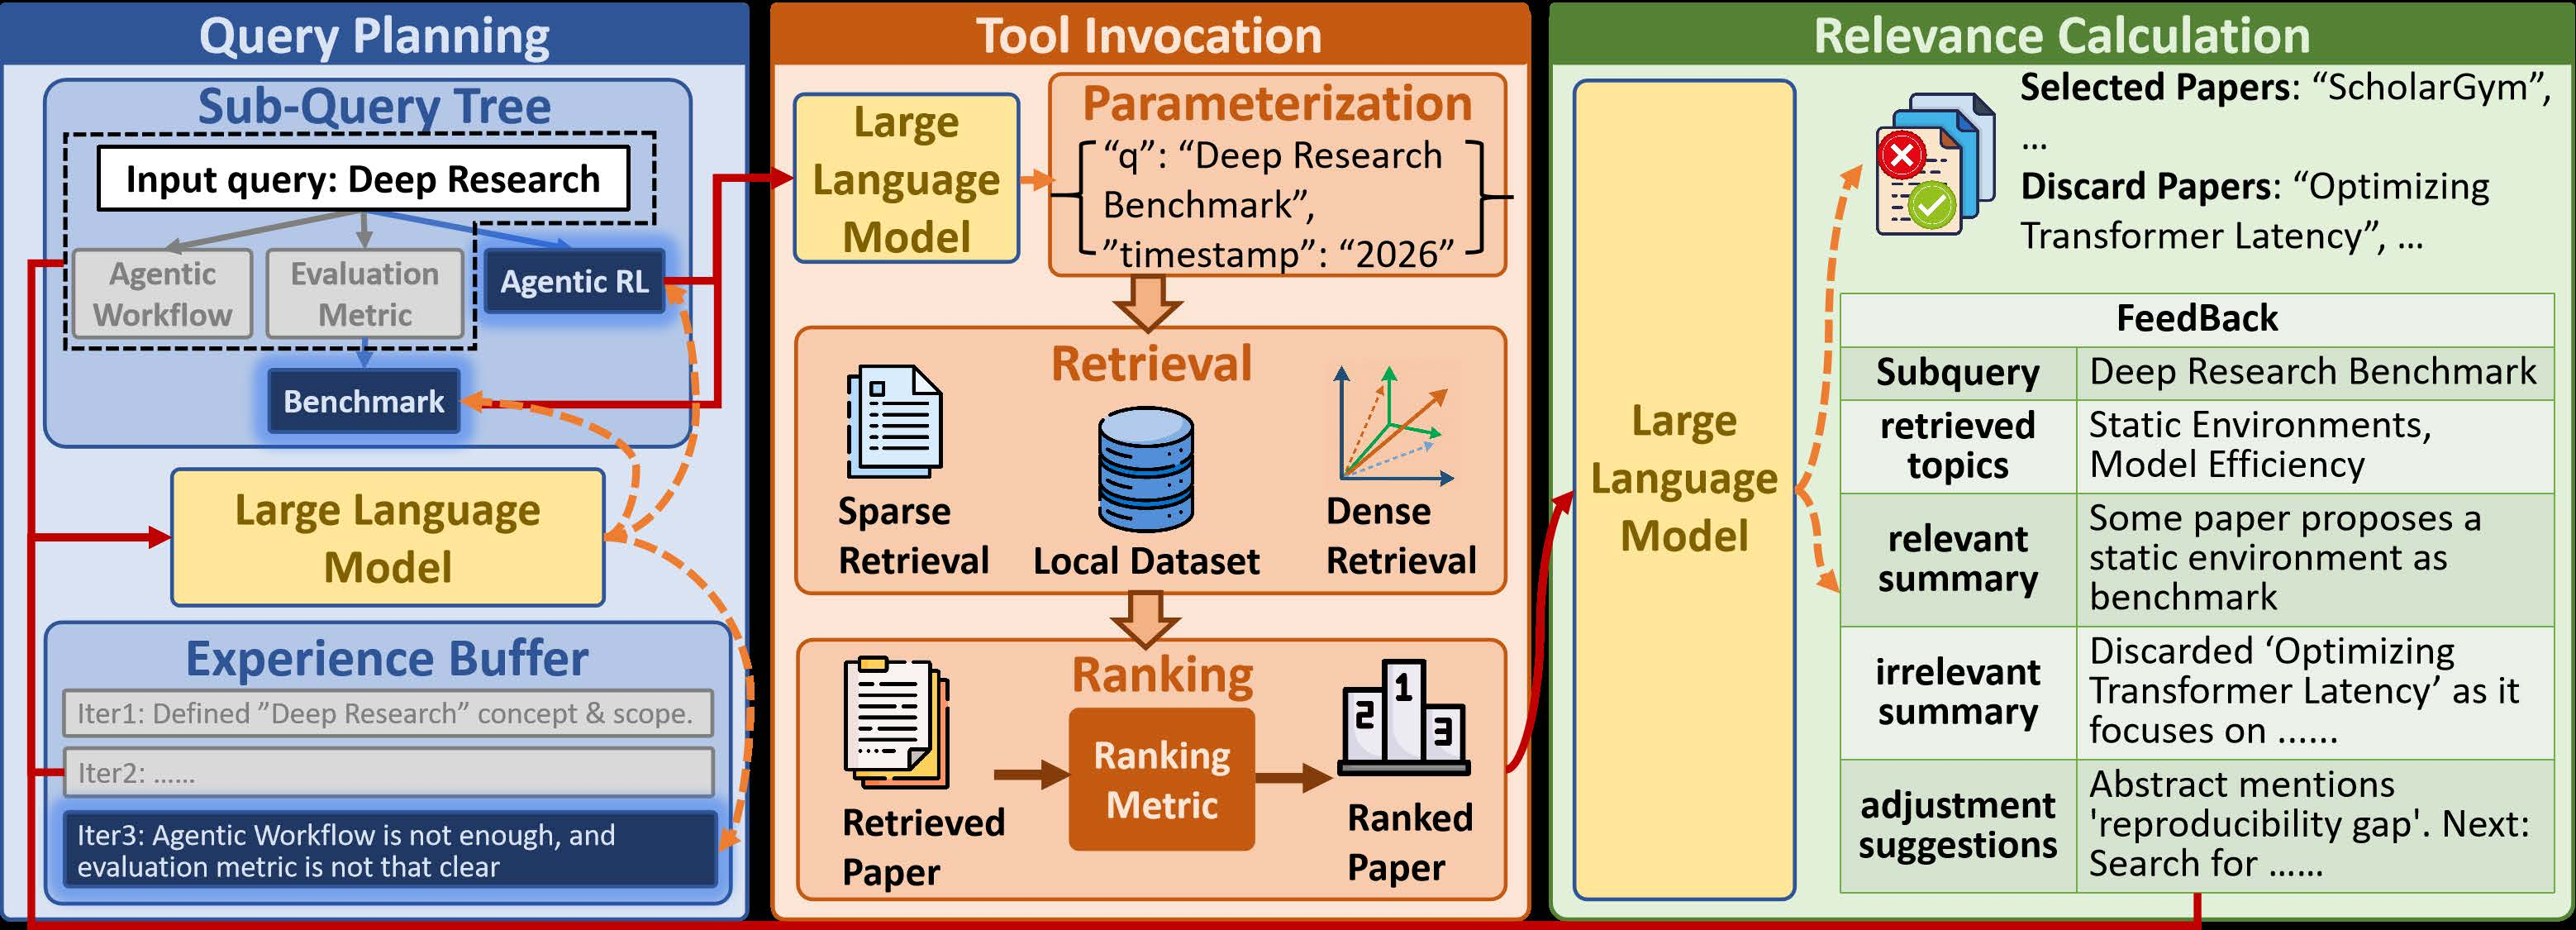
Derived from paper: ScholarGym: Benchmarking Large Language Model Capabilities in the Information-Gathering Stage of Deep Research

Preview for AIBuildAI-2
2024

AIBuildAI-2

一种具有分层外部知识的知识增强智能体,用于自动构建AI模型,解决了静态LLM知识的局限性。

Preview for jablonkagroup/rise_ai_scientists
2026

jablonkagroup/rise_ai_scientists

Corral – Rise of AI Scientists Bibliometric evidence for the rise of AI scientists in chemistry and materials science relative to general AI for chemistry 📋 Dataset Summary This dataset is part of the Corral collection accompanying the paper AI scientists produce results without reasoning scientifically. It contains the bibliometric evidence for the growing relevance and impact of AI scientists in chemistry and materials science compared to general AI… See the full description on the dataset page: https://huggingface.co/datasets/jablonkagroup/rise_ai_scientists.

task_categories:text-classificationtask_ids:multi-class-classificationannotations_creators:machine-generatedlanguage_creators:expert-generatedlanguage_creators:machine-generatedmultilinguality:monolingual
Preview for pokeandwiggle/ai-scientist-trajectories
2026

pokeandwiggle/ai-scientist-trajectories

AI Scientist trajectories Private Poke & Wiggle agent trajectories. Each run contains the original main JSONL and all subagent JSONLs in a separate directory. Credential values are redacted. Study Run Main agent Subagents ActionMap: scarce data cff59152 Trace Traces ActionMap: full data ac77530f Trace Traces DSD 4c6d8d5a Trace Traces FACT 0a082af0 Trace Traces ManiFlow c2e8e274 Trace Traces Patch Policy vs OpenVLA-OFT 8ca0c7b0 Trace Traces Patch Policy:… See the full description on the dataset page: https://huggingface.co/datasets/pokeandwiggle/ai-scientist-trajectories.

language:enarxiv:2606.06904arxiv:2609.28865arxiv:2608.01402arxiv:2509.01819arxiv:2607.18236
Preview for carps
2025

carps

Hyperparameter Optimization (HPO) is crucial to develop well-performing machine learning models. In order to ease prototyping and benchmarking of HPO methods, we propose carps, a benchmark framework for Comprehensive Automated Research Perf...

LG