研究论文、数据集与开源项目
A curated hub for AI systems that automate scientific research: literature review, survey synthesis, experiment design and execution, paper writing, AI scientists, and autonomous research agents.
自动从多来源研究论文中精选。基于 awesome-hub-generator 构建。
616论文
126数据集
12项目
0资源
18来源
分类: application · benchmark · method · survey · system · theory
最新论文
精选研究
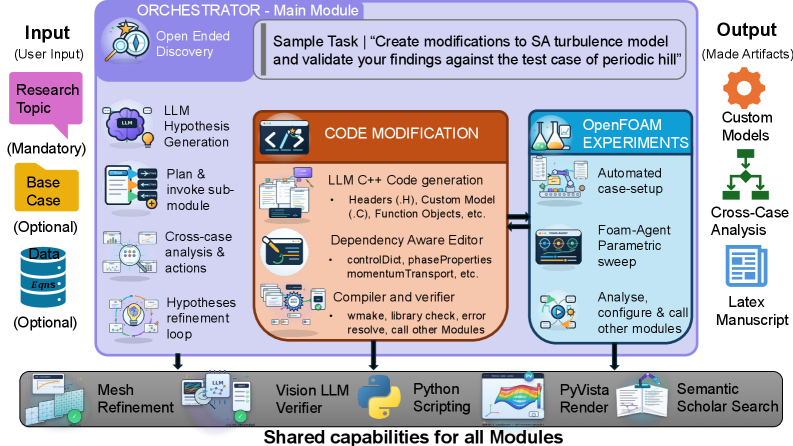
AI CFD科学家:面向开放的计算流体动力学发现,具有物理感知的AI智能体
AI CFD Scientist是一个开源AI智能体,通过物理感知验证自主进行计算流体动力学发现,在壁面Cf RMSE上实现了7.89%的改进。
flu-dynAI
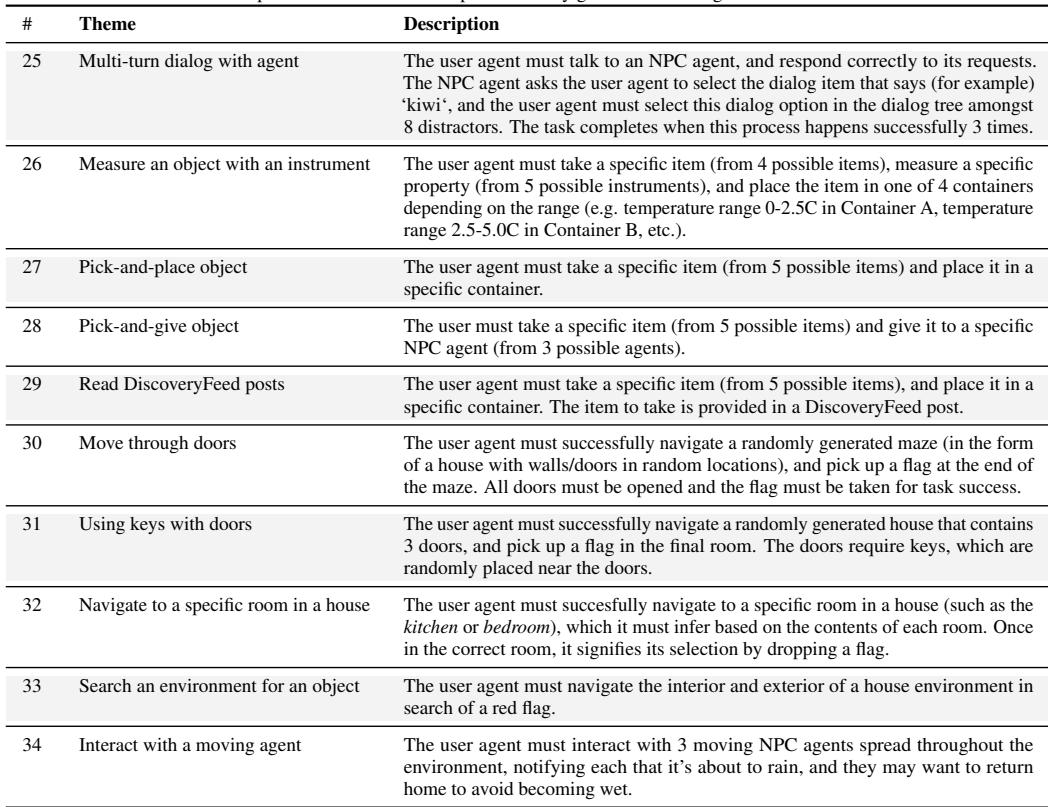
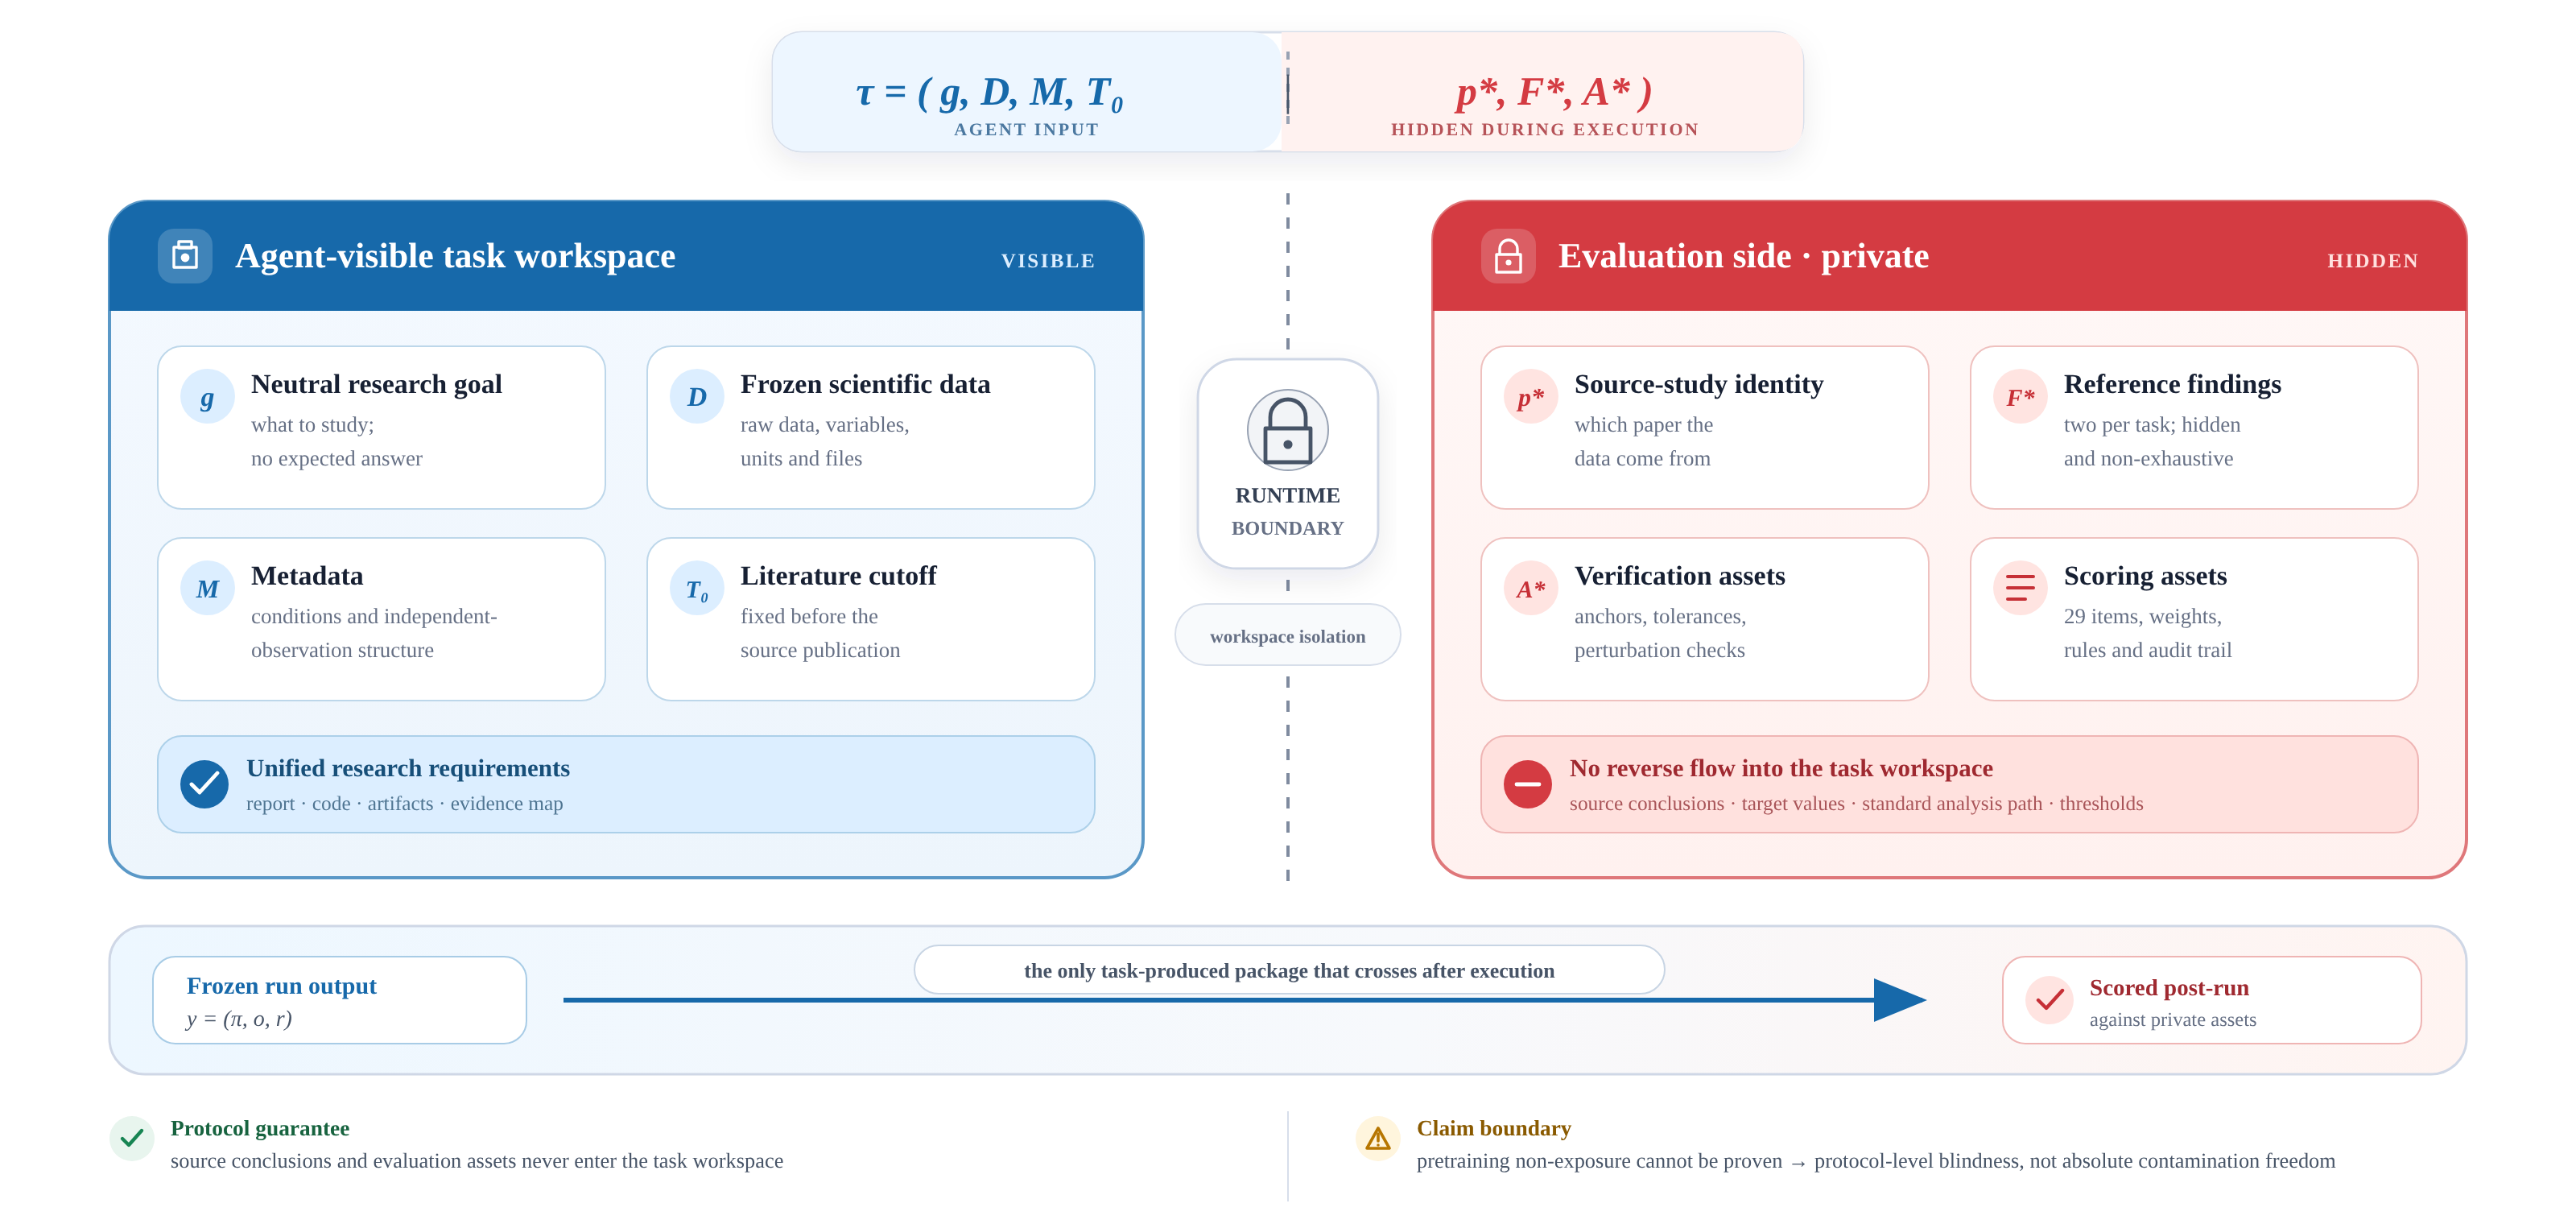
TruthInsightBench:一个基于证据的基准,用于自动评估开放式科学发现智能体
TruthInsightBench用40项盲任务评测科学发现智能体,以LLM评判证据成熟度;四个编码智能体分数相近,缺乏科学判断。
数据集
数据集大全

TruthInsightBench
自主编码智能体越来越多地被提议作为执行分析并撰写研究报告的AI科学家系统,但执行规定好的分析并不等同于做出发现。现有基准面向复现而设计:任务、数据和评分标准围绕一项隐藏的目标研究构建,并且以恢复其结果作为奖励。我们提出 TruthInsightBench,一个面向发现的基准。它包含来自10个科学领域40篇经同行评审研究的40个盲任务,仅暴露中性的科学目标和冻结数据;源结论、预期值和分析路径均被隐藏,由智能体自行判断数据支持何种主张。一个固定的基于LLM的评审器从六个维度对智能体自身主张的证据成熟度进行评分,具体化为29个基于产物(artifact)的评分项,采用自动化、确定性的聚合方式,无需逐实例人工评分,因此可在智能体迭代演进时自动重复评估。在一个冻结的基础模型上,四种编码智能体形成了一个狭窄的高原区(100分制中的58.4-60.3分),且任意两两之间均无统计上可靠的差异:它们能够熟练地执行分析并撰写文档,在证据可审计性和新颖性方面相对较强,但很大程度上缺乏建立可信主张所需的判别性行为(对照组、稳健性、可证伪性和跨数据集泛化)。瓶颈在于科学判断而非编码,真正的发现仍然遥不可及。TruthInsightBench 使这一差距成为可测量的目标;数据和评分代码位于 https://github.com/TruthInsight-stack/TruthInsightBench。
项目
GitHub 项目
GitHub
awesome-ai-research-writing
Elevate your AI research writing, no more tedious polishing ✨
Leey21
GitHub
AI-Scientist
The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery 🧑🔬
SakanaAI
GitHub
awesome-autoresearch
A curated list of autonomous improvement loops, research agents, and autoresearch-style systems inspired by Karpathy's autoresearch.
agentic-systemsai-agentsai-researchai-toolsautonomous-agentsautoresearchawesome-listclaude-code
webfuse-com