数据集大全
数据集
按表示方法和任务分组的数据集。
STEP-LLM
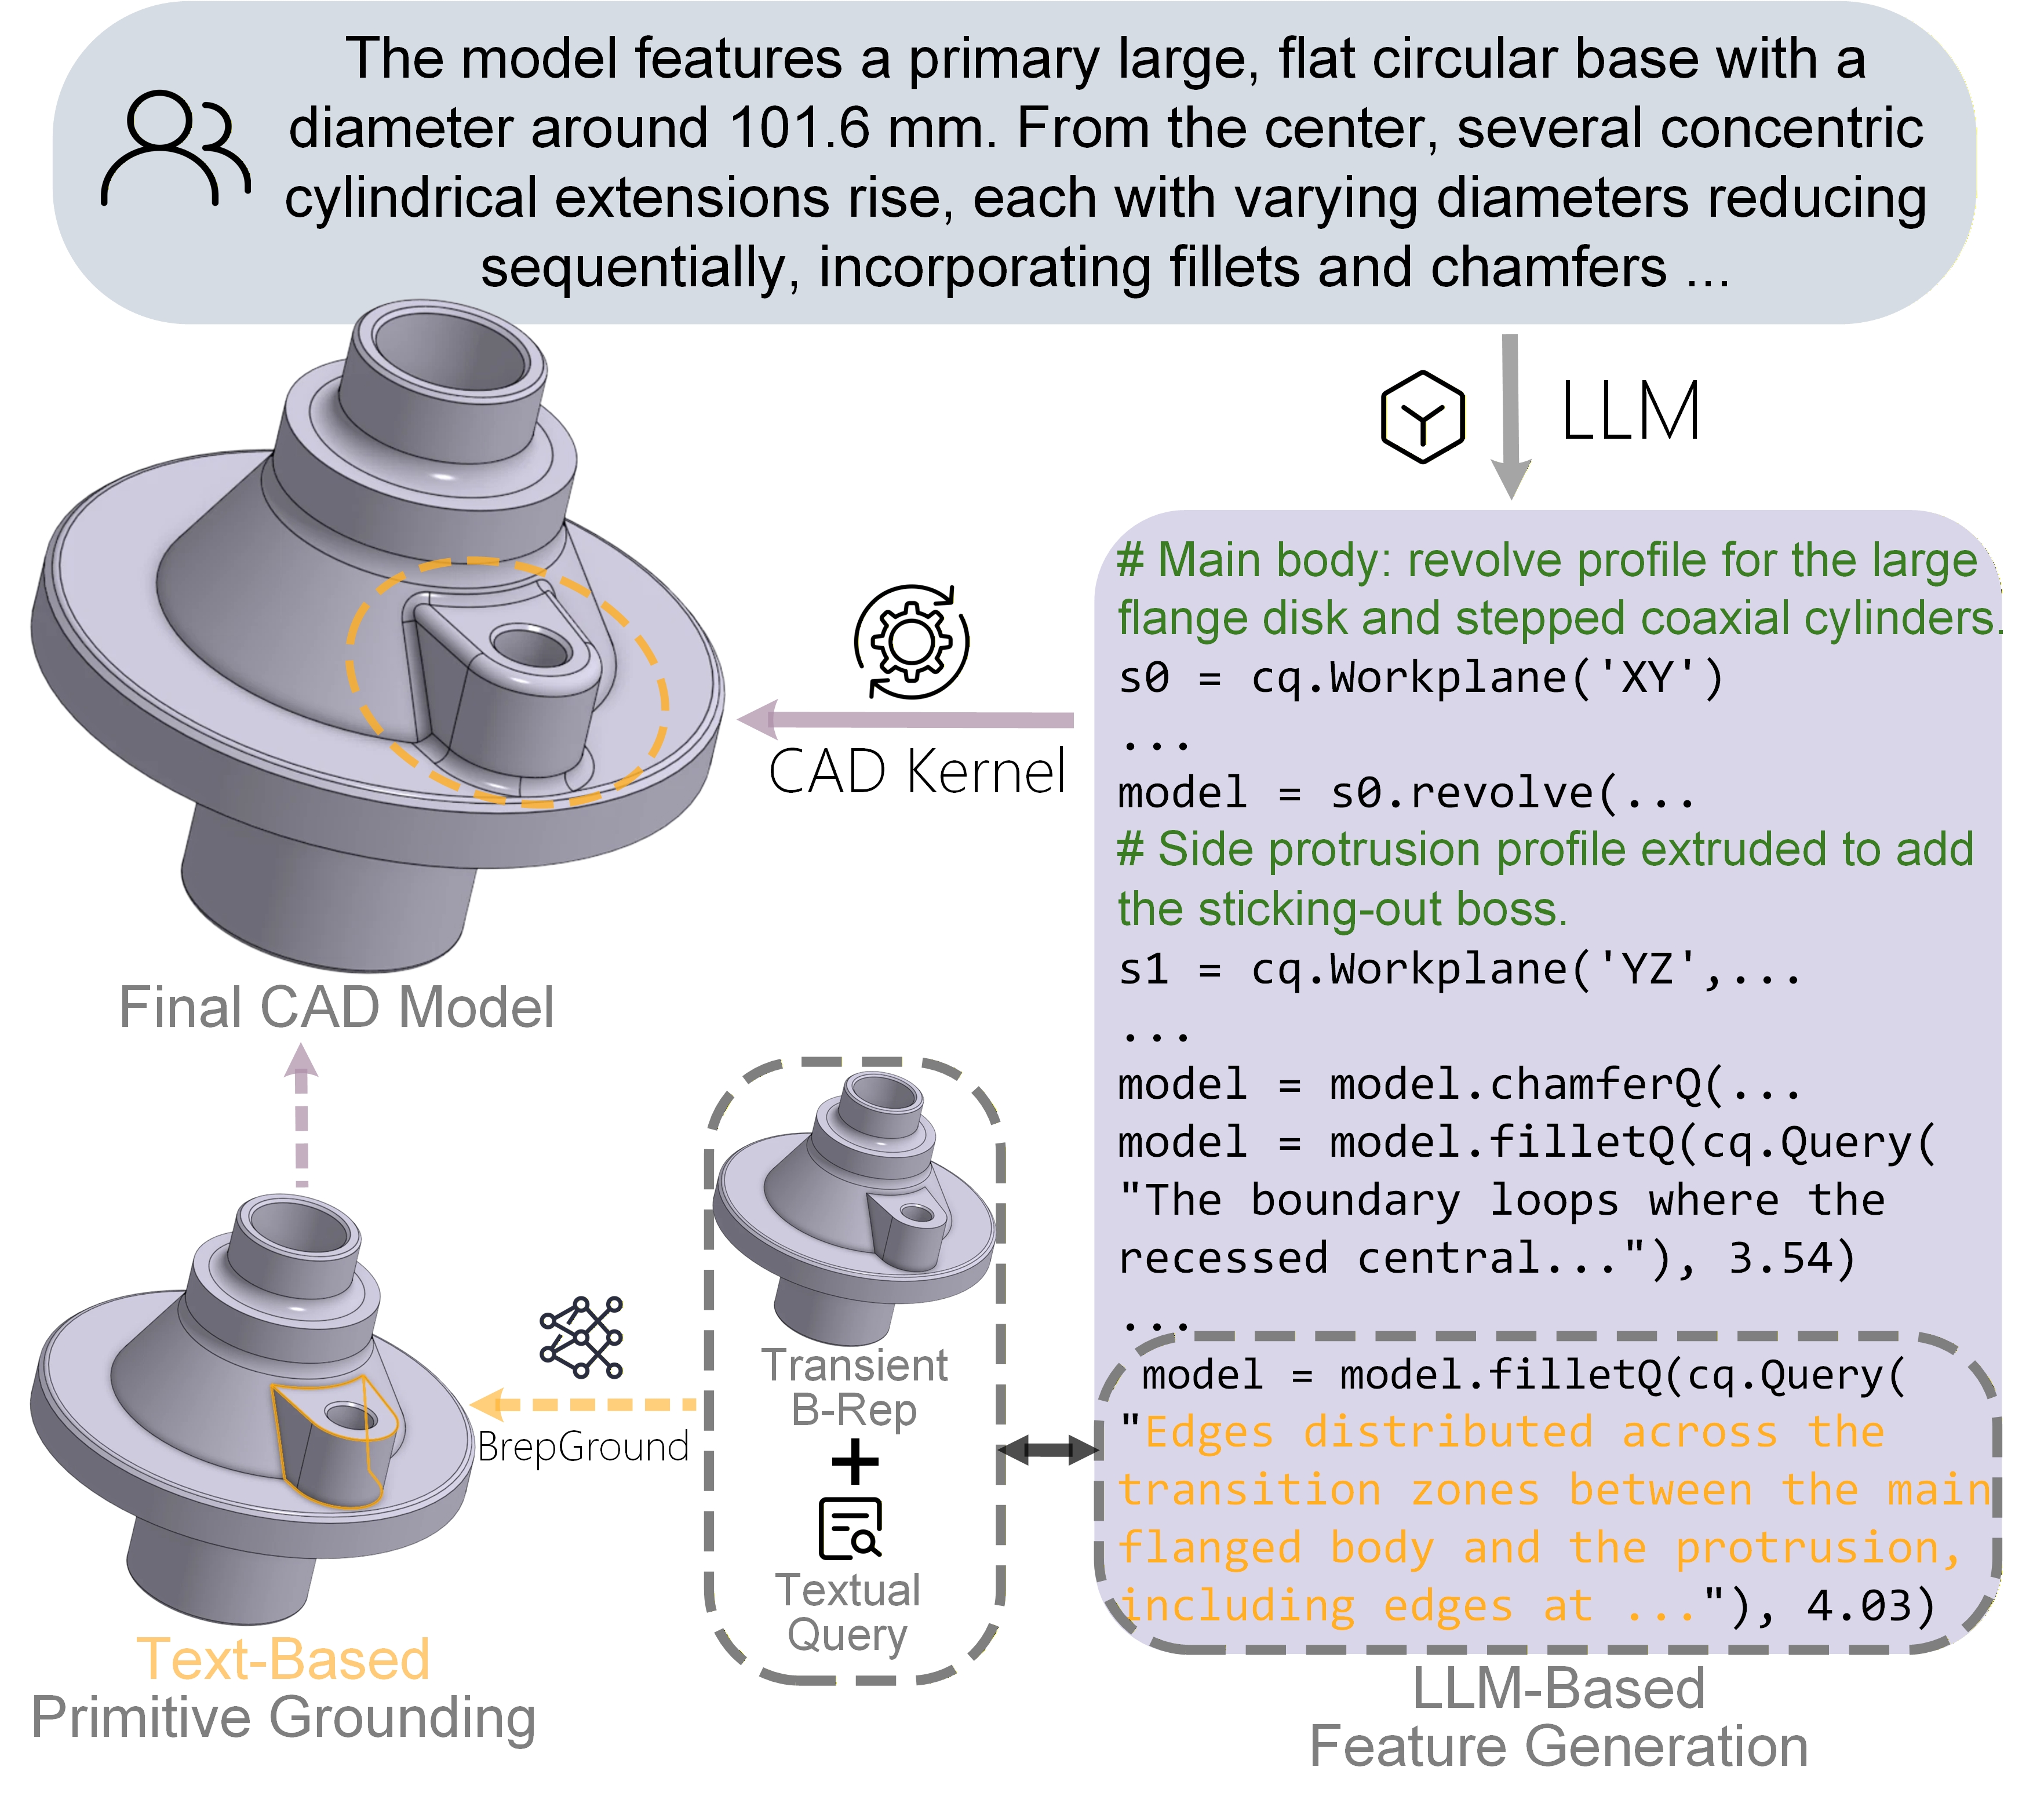
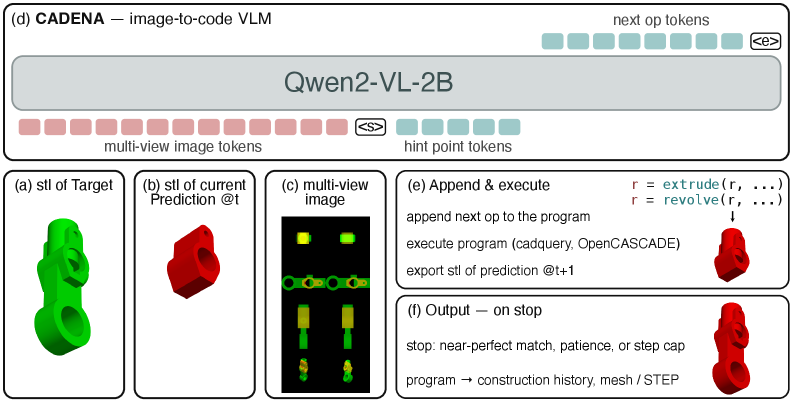
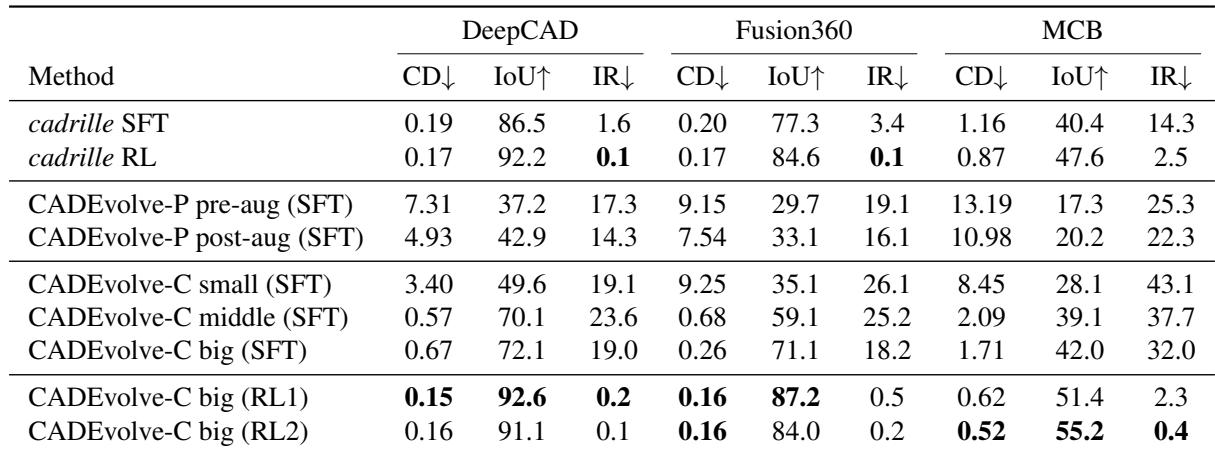
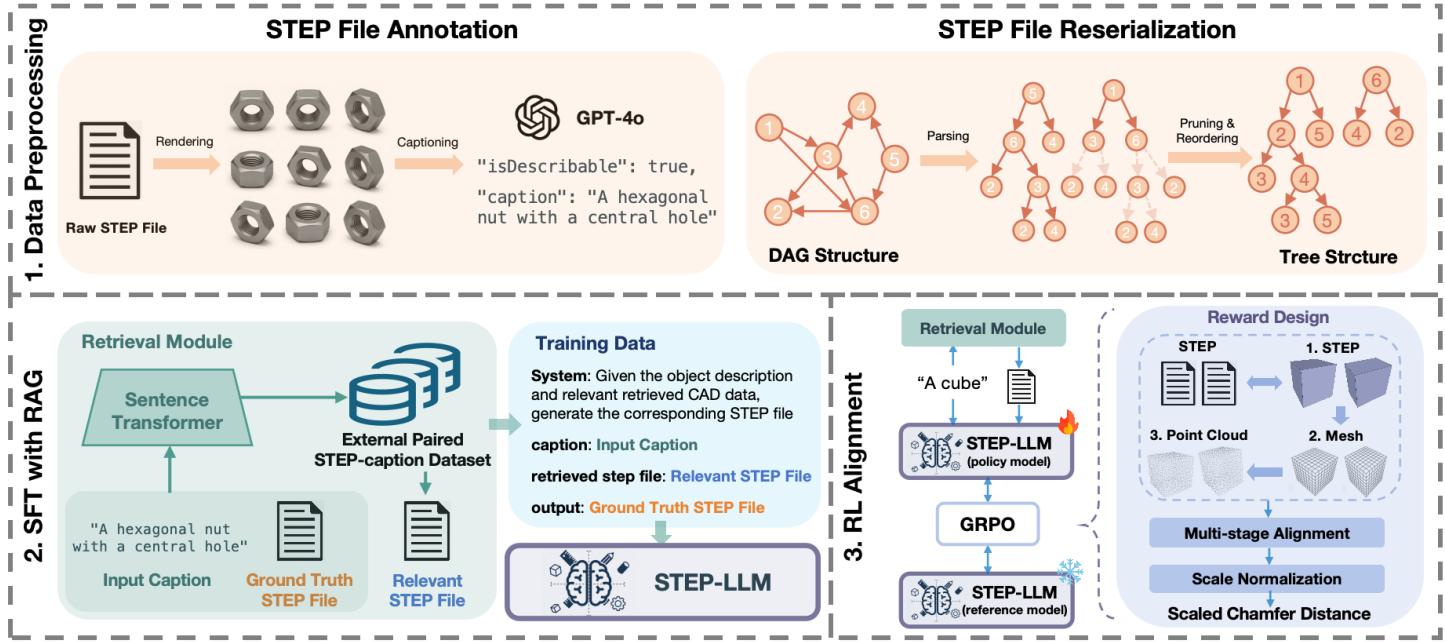
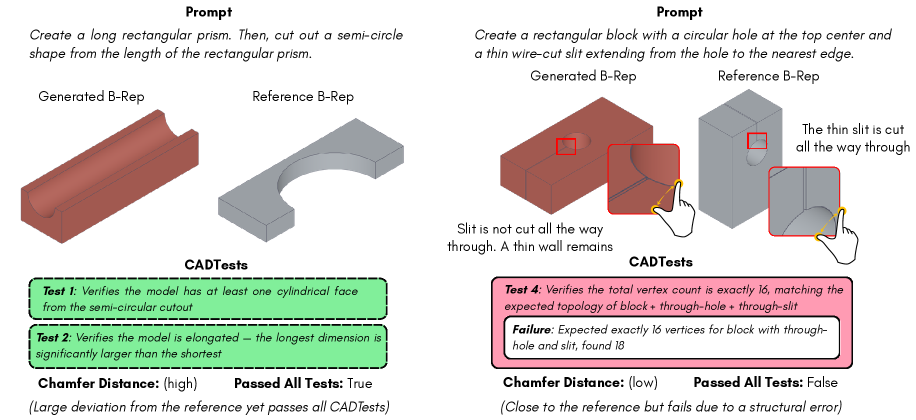
计算机辅助设计(CAD)对现代制造业至关重要,但模型创建仍然劳动密集且需要专业知识。为使非专家能够将直观的设计意图转化为可制造的工件,近期基于大型语言模型的文本到CAD工作主要关注命令序列或基于脚本的格式(如CadQuery)。然而,这些格式依赖于内核,缺乏制造领域的通用性。相比之下,产品数据交换标准(STEP,ISO 10303)文件是一种广泛采用的、中性的边界表示(B-rep)格式,可直接兼容制造,但其图结构、交叉引用的特性给自回归语言模型带来了独特挑战。为解决这一问题,我们整理了一个包含约4万个STEP-描述对的数据集,并针对STEP的图结构格式引入了新颖的预处理方法,包括基于深度优先搜索的重新序列化,在保持局部性的同时线性化交叉引用,以及链式思维(CoT)风格的结构化注释以引导全局一致性。我们集成了检索增强生成,将预测基于相关示例进行监督微调,并通过强化学习结合基于倒角距离的几何奖励来优化生成质量。实验表明,我们的STEP-LLM在几何保真度上相较于Text2CAD基线持续提升,这些改进源于我们框架的多个阶段:RAG模块显著增强了完整性和可渲染性,基于DFS的重新序列化提高了整体准确性,而强化学习进一步减少了几何差异。指标和视觉比较均证实STEP-LLM生成的形状比Text2CAD具有更高的保真度。这些结果展示了从自然语言驱动STEP模型生成的可行性,显示了其在制造领域民主化CAD设计的潜力。
AI
Pointer-CAD v2
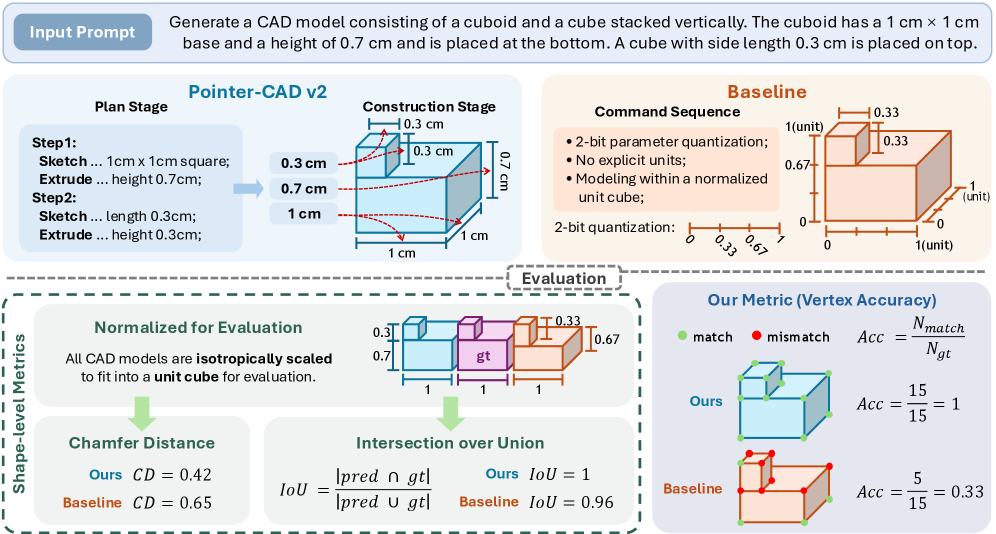
计算机辅助设计(CAD)通过提供工业生产所需的高精度,在现代制造业中发挥着基础性作用。近期基于大语言模型的方法将CAD生成建模为序列预测问题,并取得了令人瞩目的成果。然而,现有方法与评估协议主要强调视觉相似性,而忽略了精确的几何参数与正确的度量尺度。在形状层面可忽略的微小数值偏差仍可能违反工业公差要求,而当前采用命令序列表示的自回归范式为了简化大语言模型的预测,对数值参数进行了激进量化,进一步加剧了这一问题。在本工作中,我们提出了Pointer-CAD v2。与v1版本(arXiv:2603.04337)相比,本版本直接预测连续值,无需量化数值参数,从而消除了量化误差。具体而言,我们提出了一种统一框架,通过“先规划后构建”范式将参数推理与几何构建解耦。我们的方法首先生成一个包含显式度量尺度参数的结构化设计规划。这些参数被组织成字典,并通过指针机制在序列生成过程中直接引用,从而消除了离散化误差并确保了维度一致的执行。此外,我们构建了一个带有规划级标注的大规模新数据集,并引入了三个层次化的几何精度度量指标,以在顶点、边和面层级评估参数保真度。大量实验表明,Pointer-CAD v2持续优于现有基线,并在几何精度上取得了显著提升,从而为精度关键的工程应用提供了可靠的CAD生成。
CVCL
CGGT
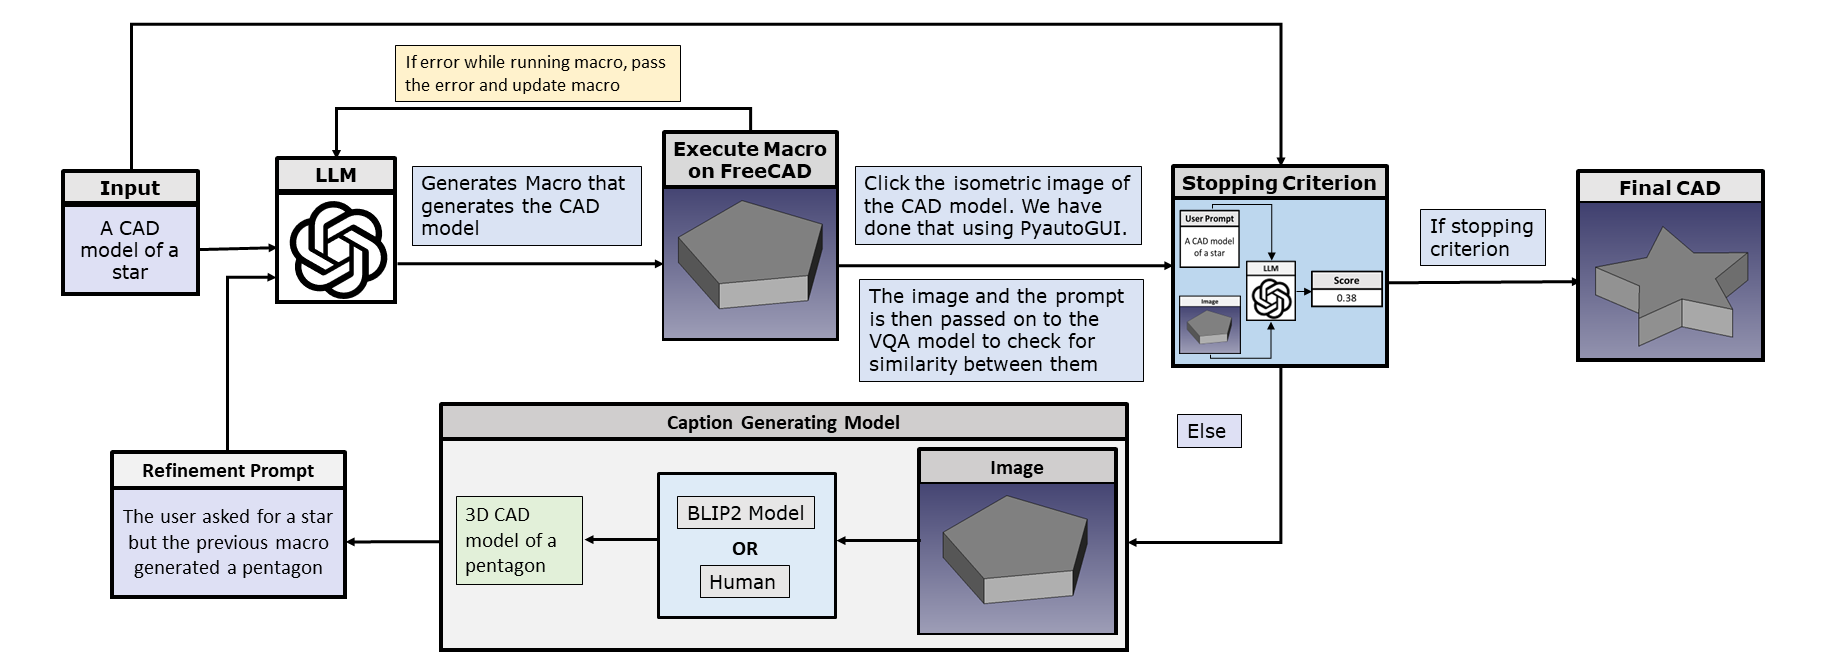
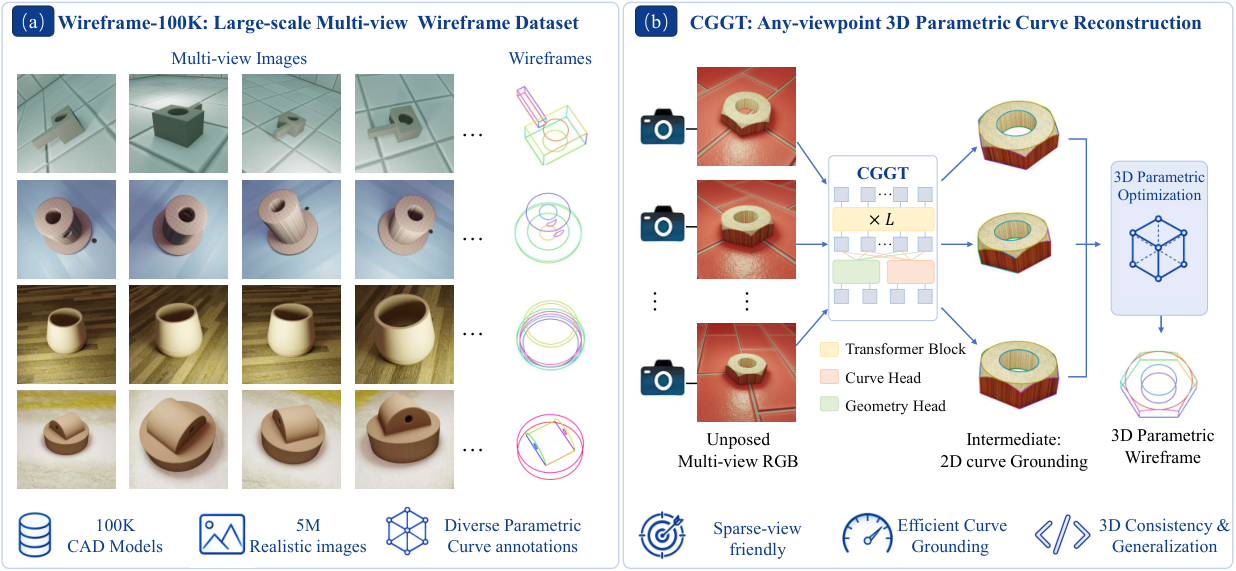
从二维图像恢复可编辑的三维参数曲线是计算机图形学中的一个基本挑战,它连接了基于像素的感知与基于矢量的CAD建模。现有的基于NeRF和3DGS的方法通常依赖密集的已标定视图、预计算的二维边缘图以及昂贵的逐场景优化,限制了其在随意拍摄的真实世界输入上的适用性。我们提出CGGT,一种曲线锚定的几何Transformer(Curve-Grounded Geometry Transformer),能够直接从稀疏、无位姿的多视图图像中,在图像空间内确定具有三维一致性的二维曲线实例。CGGT结合了用于多视图特征学习的几何感知Transformer编码器,以及用于跨视图实例关联的曲线感知掩码注意力解码器。在单次前向传播中,它预测相机参数、稠密深度图和实例级二维曲线掩码;这些结果随后被提升到三维,并通过一个快速的参数优化阶段进行细化,以恢复紧凑、可编辑的三维曲线基元。为支持结构化曲线学习,我们引入了Wireframe-100K,这是一个大规模数据集,包含10万个具有多样拓扑结构的CAD模型、真实感多视图渲染和精确的参数曲线标注。大量实验表明,我们的框架在重建准确性和效率方面均取得了显著提升,尤其是在具有挑战性的稀疏视图设置下,以及在将持久的3D结构边缘与由轮廓、纹理和外观变化引起的视图相关图像边缘区分开来的任务中。尽管仅在合成数据上训练,CGGT仍能很好地泛化到真实世界图像,展示了其从无约束视觉输入进行实用CAD风格线框重建的潜力。
FllumaOne
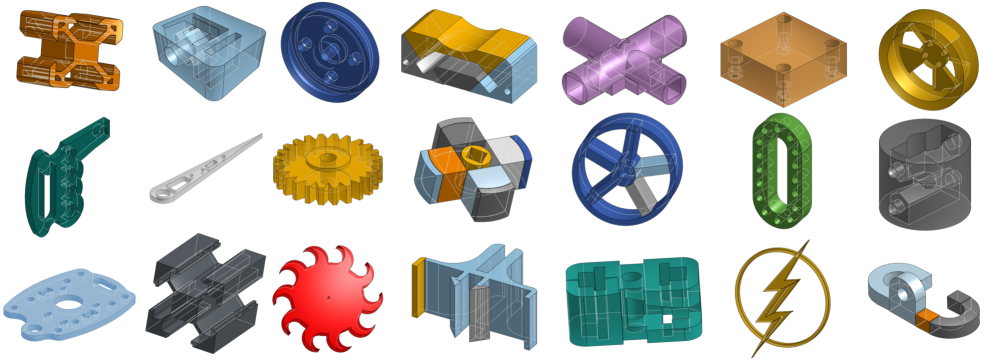
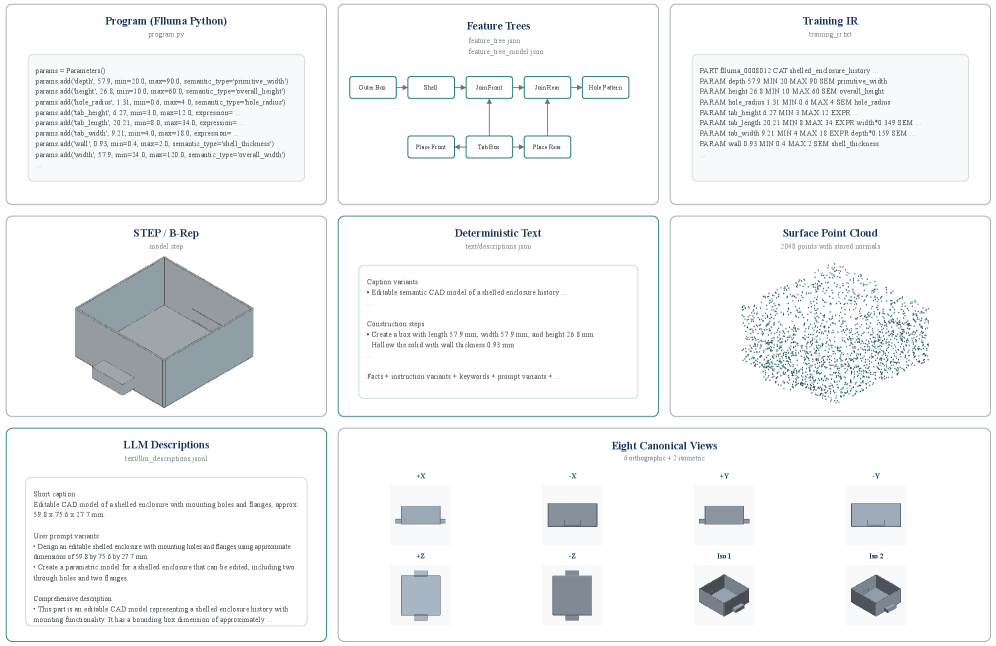
参数化计算机辅助设计不仅记录最终几何形状,还记录有序的构建历史,该历史决定了零件如何被编辑。用于可编辑CAD研究的数据集应同时暴露建模操作、参数和特征依赖关系以及经过验证的几何形状。我们介绍了FllumaOne,一个代码原生的多模态CAD数据集,其模型由基于Qt/C++ OpenCASCADE的CAD系统Flluma中的可执行Python程序生成。每个样本将其程序与结构化特征树、面向训练的中间表示、STEP几何、表面点云、自然语言描述、元数据和八种标准可见边缘渲染图对齐。主要发布版本FllumaOne-100K包含100,000个通过四种模板级复杂度区间接受的样本。程序仅在通过内核几何、实体有效性和导出检查后执行并保留;发布报告还记录了模态完整性和分割级别重复测试。基于Qwen2.5-Coder-1.5B LoRA的基线模型在80,000个样本上训练,在保留的10,000样本测试集上实现了99.98%的Python语法有效性、99.97%的Flluma构建成功率和99.14%的STEP导出有效性。对于转换为表面点云的9,909个预测,平均归一化倒角距离为0.002124。该数据集支持条件化CAD重建、可执行程序合成、特征树预测、B-Rep分析、检索、设计补全和可编辑逆向工程。
AIGR
Masked BRep Autoencoder via Hierarchical Graph Transformer
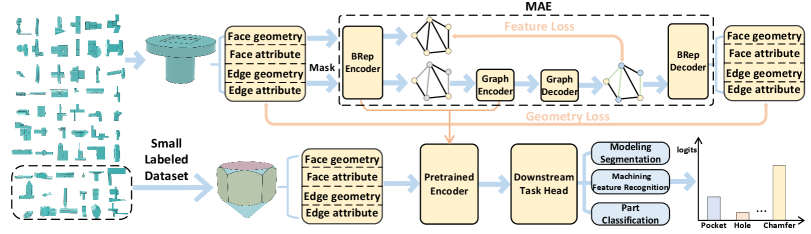
我们提出了一种新颖的自监督学习框架,能够自动从输入的计算机辅助设计(CAD)模型中学习表示,用于下游任务,包括零件分类、建模分割和加工特征识别。为了训练我们的网络,我们构建了一个大规模、无标注的边界表示(BRep)模型数据集。我们算法的成功依赖于两个关键组件。第一个是掩码图自编码器,它通过重建BRep中随机掩码的几何和属性来进行表示学习,从而增强泛化能力。第二个是层次化图Transformer架构,通过跨尺度互注意力块优雅地融合全局和局部学习,以建模长程几何依赖关系,并通过图神经网络块聚合局部拓扑信息。在训练自编码器后,我们将其解码器替换为在少量标注数据上训练的任务特定网络,用于下游任务。我们在各种任务上进行了实验,即使使用少量标注数据也取得了高性能,证明了我们模型的实用性和泛化能力。与其他方法相比,我们的模型在相同训练数据量下,尤其是在训练数据非常有限时,在下游任务上表现显著更好。
GRLG
面向计算机辅助设计的大型语言模型(LLM4CAD)微调
微调GPT-3.5模型于新多模态CAD数据集,提升文本到CAD生成,用解析率和IoU评估。
GraphCAD
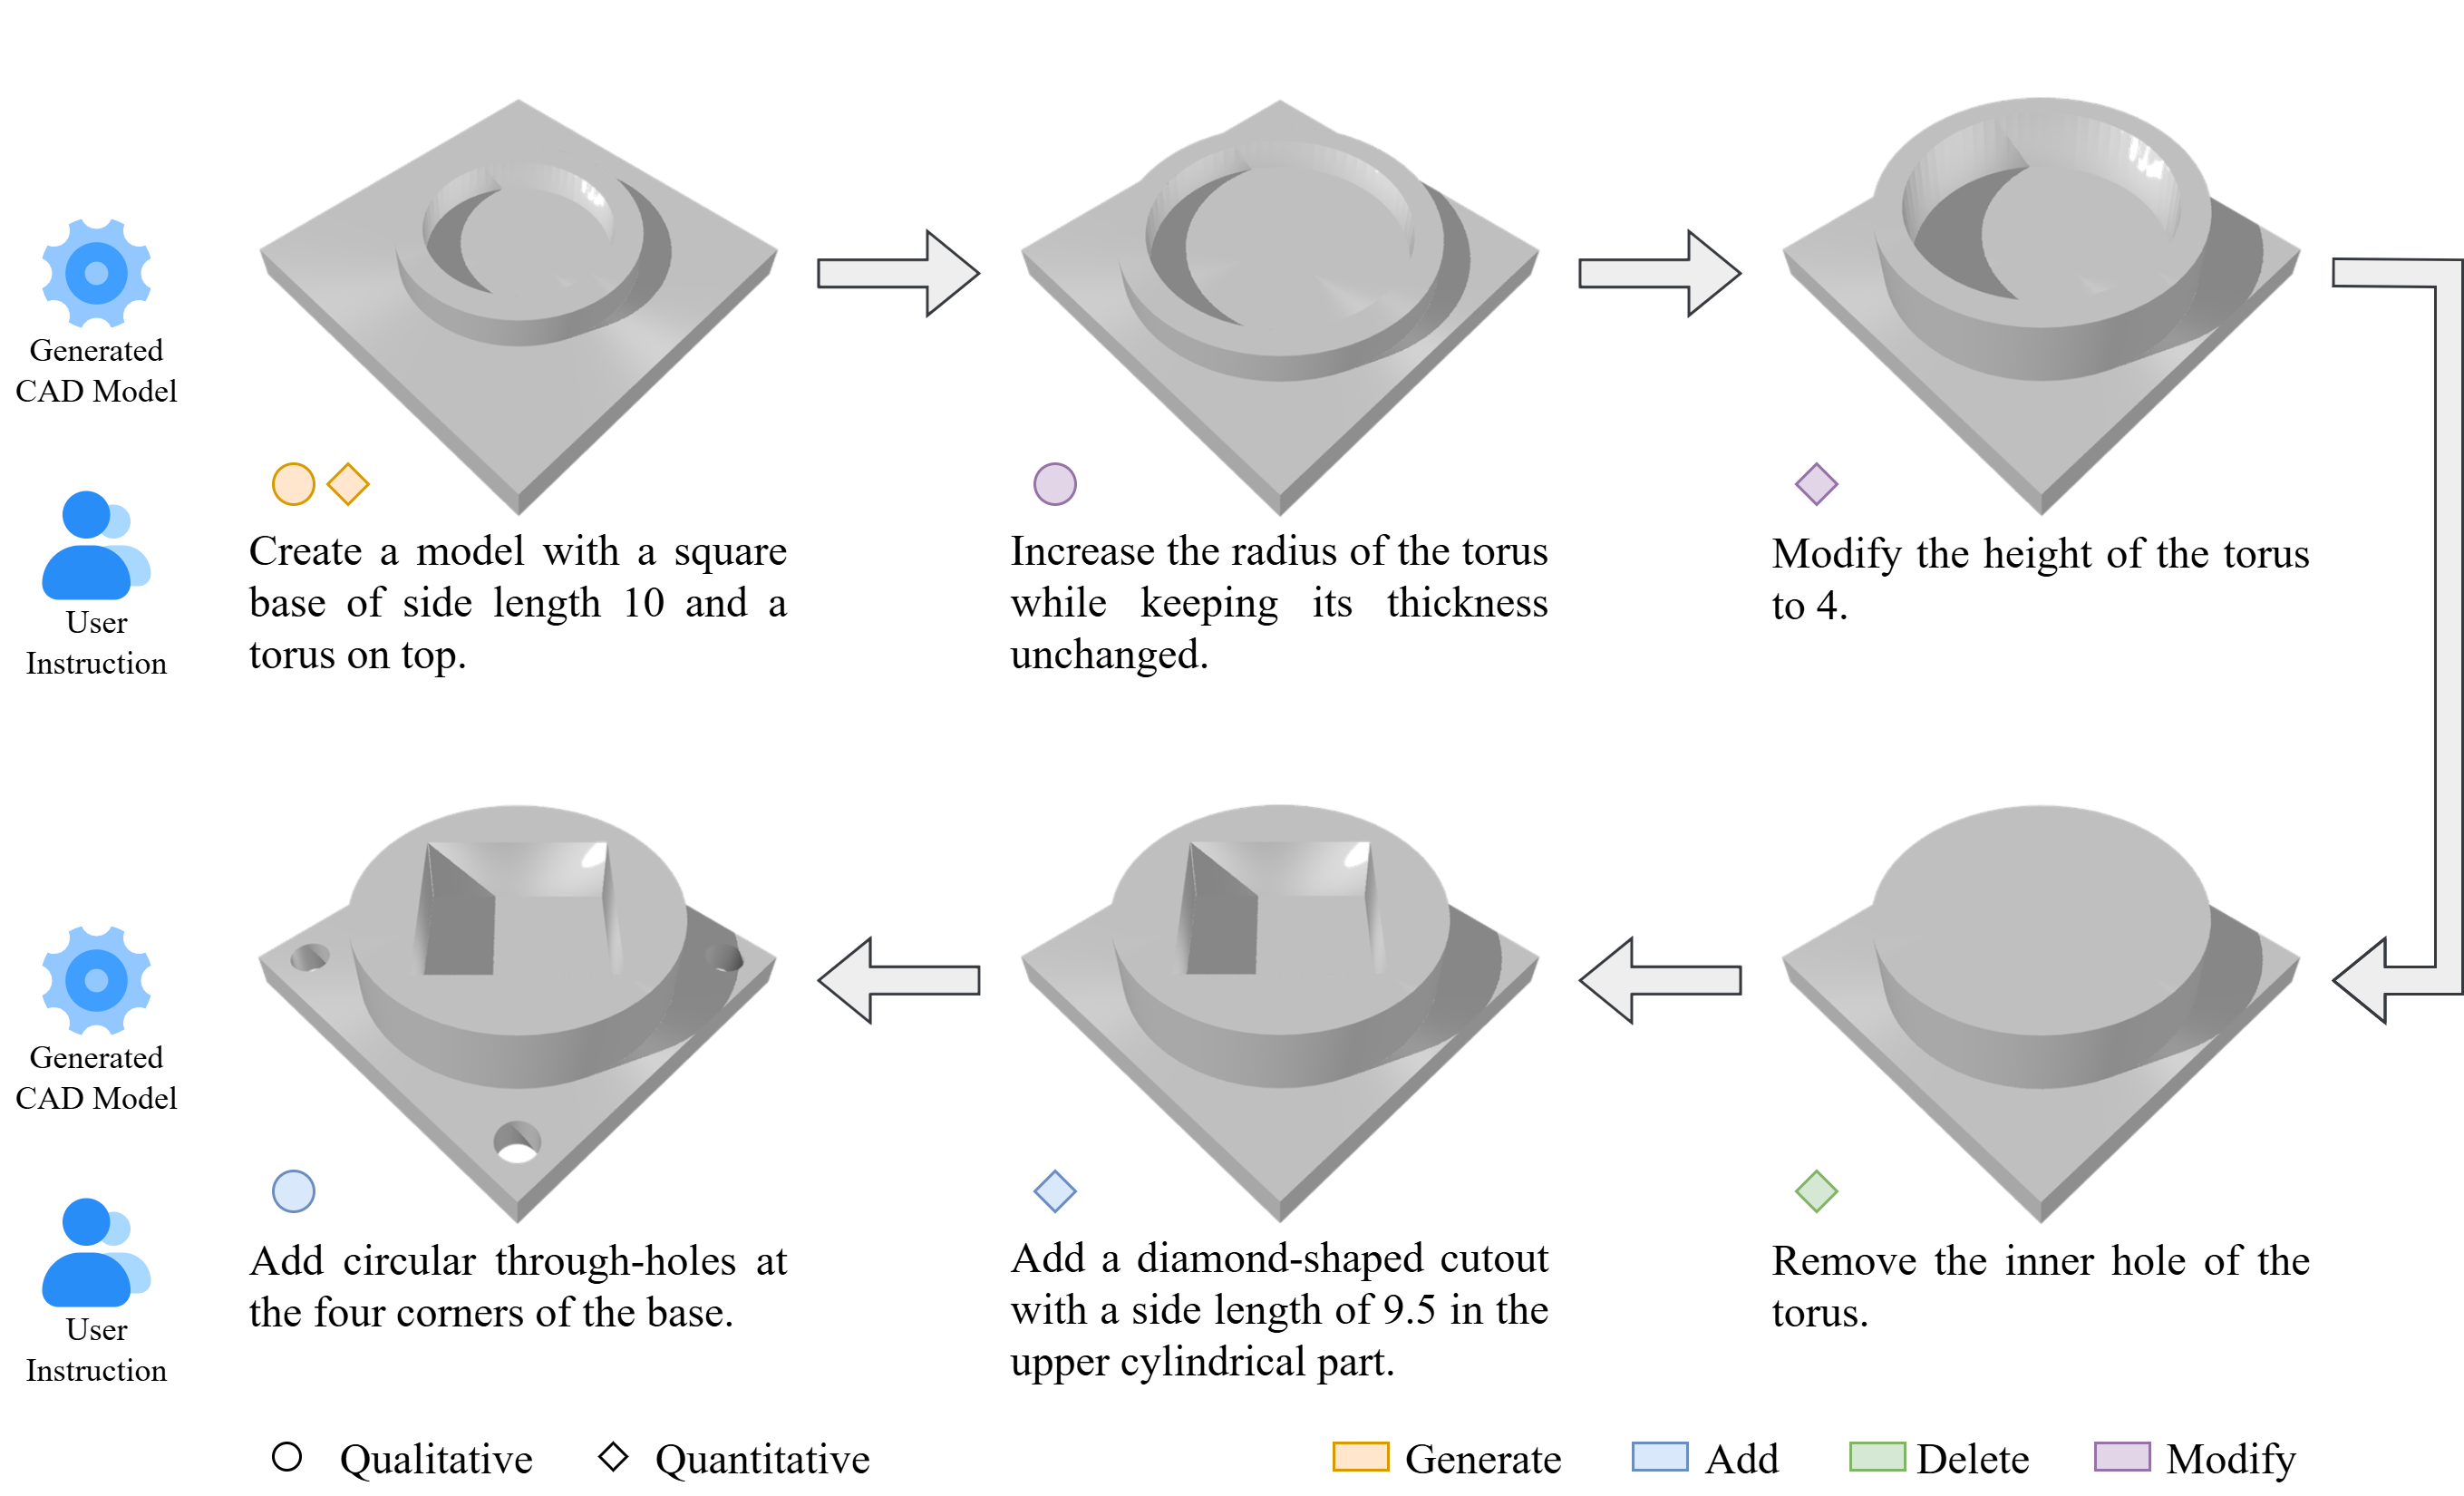
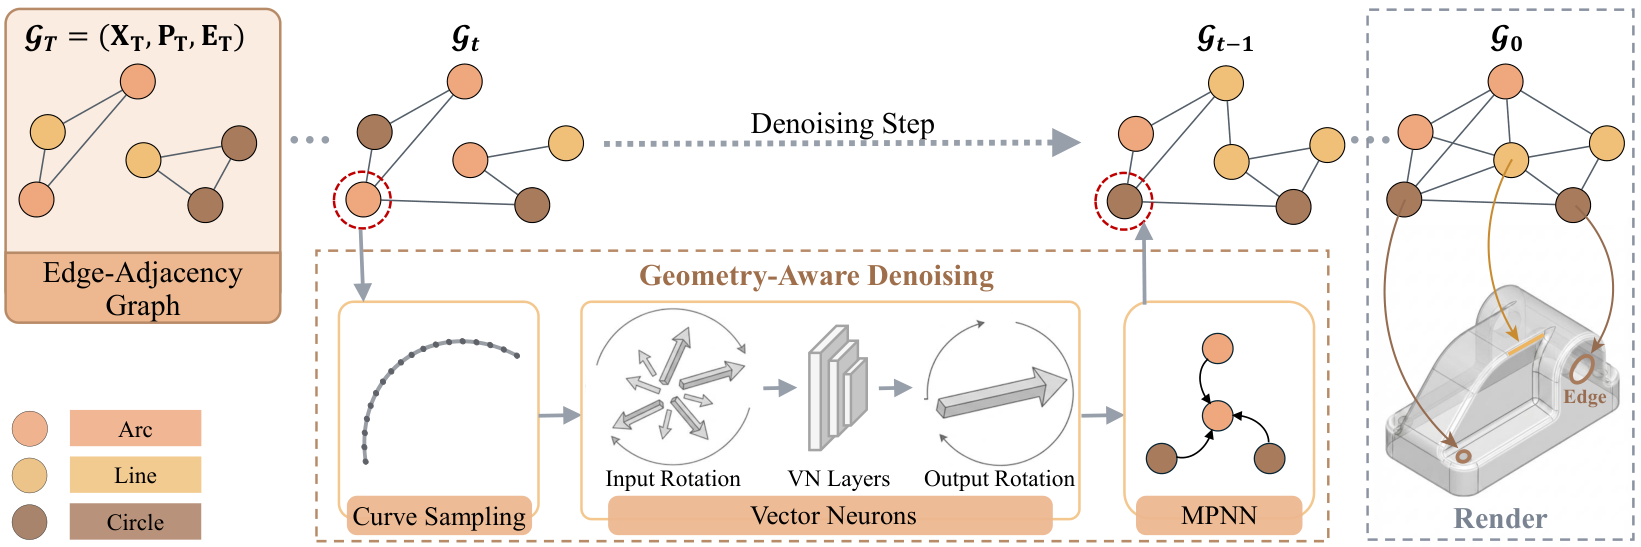
面向计算机辅助设计(CAD)的生成建模面临根本性挑战,即需要捕捉边界表示(B-reps)中离散拓扑连接与精确空间几何之间错综复杂的相互作用。现有生成方法大多将CAD构建形式化为序列建模问题,因而缺乏显式的拓扑归纳偏置。在本工作中,我们提出GraphCAD,一种几何感知生成框架,其建模核心是边邻接图(EAG)——一种专为生成任务设计的基于图的CAD表示。GraphCAD采用混合图扩散公式来联合建模EAG的离散与连续分量,并引入一种几何感知去噪机制,将节点属性渲染为空间点集。这些点集由SE(3)-等变主干网络编码并融合到节点表示中,从而将生成过程锚定于物理几何。为支撑本研究,我们构建了EAGBench,一个大规模工程CAD模型数据集。大量实验表明,GraphCAD能够生成包含50多个面的复杂CAD模型,并与基于序列的基线相比,在几何保真度和分布对齐方面取得了最先进的性能。
Pointer-CAD v2
计算机辅助设计(CAD)通过提供工业生产所需的高精度,在现代制造业中发挥着基础性作用。近期基于大语言模型的方法将CAD生成建模为序列预测问题,并取得了令人瞩目的成果。然而,现有方法与评估协议主要强调视觉相似性,而忽略了精确的几何参数与正确的度量尺度。在形状层面可忽略的微小数值偏差仍可能违反工业公差要求,而当前采用命令序列表示的自回归范式为了简化大语言模型的预测,对数值参数进行了激进量化,进一步加剧了这一问题。在本工作中,我们提出了Pointer-CAD v2。与v1版本(arXiv:2603.04337)相比,本版本直接预测连续值,无需量化数值参数,从而消除了量化误差。具体而言,我们提出了一种统一框架,通过“先规划后构建”范式将参数推理与几何构建解耦。我们的方法首先生成一个包含显式度量尺度参数的结构化设计规划。这些参数被组织成字典,并通过指针机制在序列生成过程中直接引用,从而消除了离散化误差并确保了维度一致的执行。此外,我们构建了一个带有规划级标注的大规模新数据集,并引入了三个层次化的几何精度度量指标,以在顶点、边和面层级评估参数保真度。大量实验表明,Pointer-CAD v2持续优于现有基线,并在几何精度上取得了显著提升,从而为精度关键的工程应用提供了可靠的CAD生成。
CV
支持高级三维形状学习的参数化与基于特征的CAD数据集以促进人机交互
首个带选择机制的参数化与基于特征的CAD数据集,支持人机交互的高级三维形状学习。
Revisiting CAD Model Generation by Learning Raster Sketch
Derived from paper: Revisiting CAD Model Generation by Learning Raster Sketch
CAD Translator
一种使用对比学习和融合嵌入的文本到参数化CAD生成的新型编码器-解码器框架。
HoW-3D
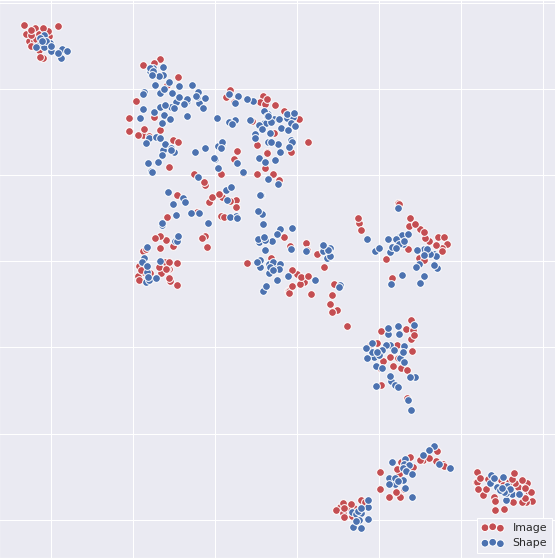
本文研究了整体三维线框感知(HoW-3D)问题,这是一个从单视图二维图像中同时感知可见和不可见三维线框的新任务。由于物体的非正面表面无法在单视图中直接观察,估计HoW-3D中的非视线(NLOS)几何结构是一个根本性的挑战性问题,在计算机视觉中仍未解决。我们通过提出ABC-HoW基准来研究HoW-3D问题,该基准基于来自ABC-dataset的CAD模型构建,包含12k张单视图图像及对应的整体三维线框模型。借助我们的大规模ABC-HoW基准,我们提出了一种新颖的深度空间格式塔(DSG)模型,该模型以学习可见的角点和线段为基础,然后遵循人类视觉系统的格式塔原理,从可见线索推断NLOS三维结构。在我们的实验中,我们证明了DSG模型在从单视图图像推断整体三维线框方面表现非常出色。与强基线方法相比,我们的DSG模型在检测单视图图像中的不可见线几何结构方面优于先前的线框检测器,甚至在以高保真点云作为输入的三维线框重建任务中,也与现有先进方法具有竞争力。
Slice-100K
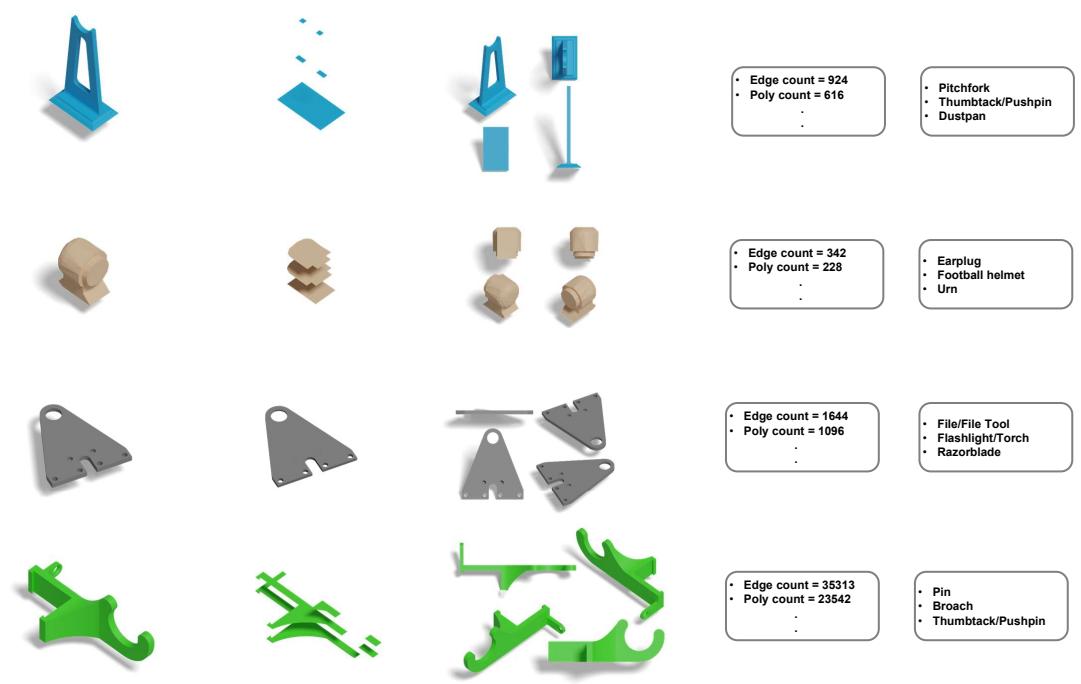
Derived from paper: Slice-100K: A Multimodal Dataset for Extrusion-based 3D Printing
CADWorld
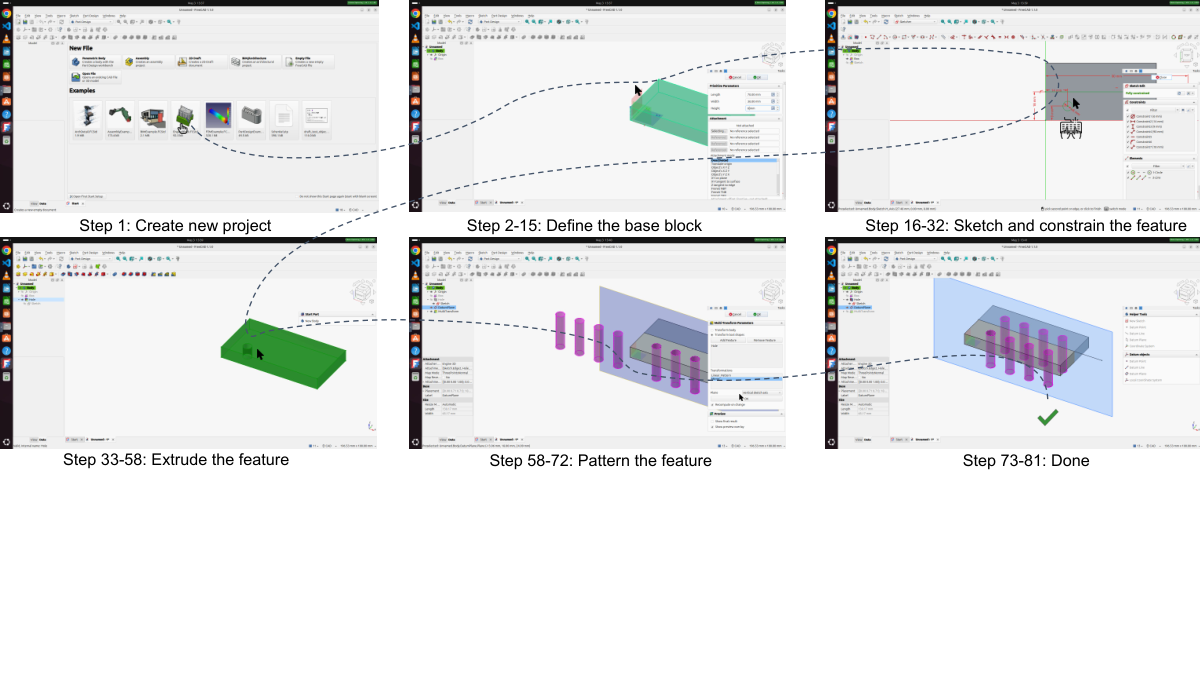
计算机使用智能体越来越多地在真实桌面环境中进行评估,但现有基准对输出为持久、结构化工件的专业工程工作流的覆盖有限。机械计算机辅助设计(CAD)是一个特别严苛的场景:智能体必须在长时间交互跨度内操控几何和约束,同时生成一个尺寸、构造结构和下游工程状态均保持有效的原生项目。我们提出了 CADWorld,一个面向 FreeCAD 中长周期计算机使用的基准。CADWorld 包含 200 个任务,涵盖 11 个机械 CAD 工作流类别,包括草图绘制、零件建模、装配、CAM、FEM、测量、网格处理和技术制图。智能体通过截图和 GUI 操作进行交互,而成功与否由针对已保存的 FreeCAD 工件和辅助输出的任务特定可执行检查判定,涵盖几何属性、参数化结构、约束、制造状态和仿真结果。在完整基准测试中,七个当前智能体里最强的智能体仅达到 17.5% 的成功率,而专家参考通过率为 87.0%。我们发现,较弱的智能体往往在生成有效工件之前就失败,而较强的智能体则越来越多地在结构、几何和构造过程要求上失败。因此,CADWorld 揭示了通用 GUI 能力与持久、可验证工程工作流的可靠执行之间的差距。项目可访问 https://cad-world.github.io。
Vision2CAD
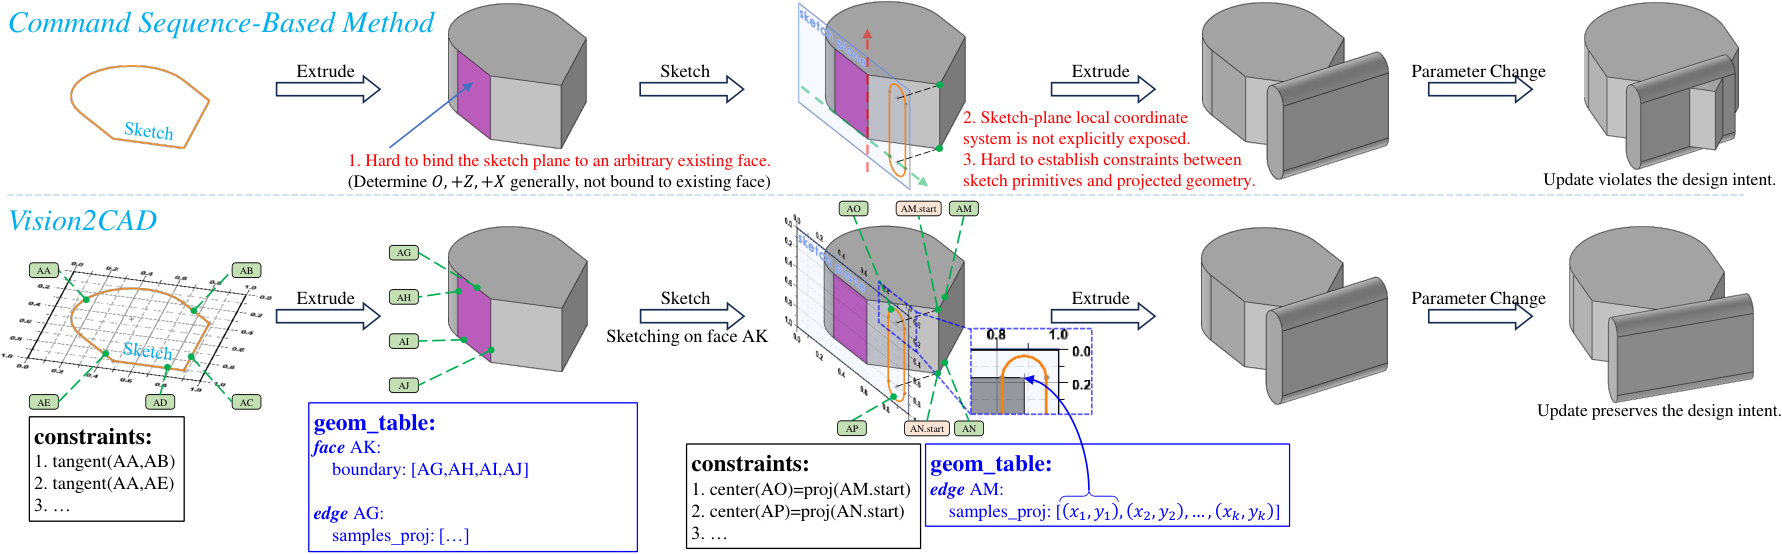
生成参数化CAD模型需要精确的几何和稳定的特征依赖关系。现有方法在选择几何参考、解释草图平面局部坐标以及建立相对于投影外部几何的草图约束方面面临挑战。我们提出Vision2CAD,一种将视觉语言模型(VLM)推理与确定性CAD内核操作相结合的视觉智能体工具框架。基于ID的接口支持显式几何选择,局部坐标桥将视图坐标转换为草图坐标,投影边定位支持外部草图约束。这些机制在支持的建模操作和约束类型内建立了特征依赖关系。我们还引入了几何显式引用数据集(GERD),该数据集在每个建模步骤中对齐了命令、几何状态和ID。在GERD-EVL和DeepCAD测试子集上,Vision2CAD将mIoU分别提高了11.1%和5.6%,并将Chamfer距离分别降低了17.3%和41.8%。参数编辑实验和消融研究进一步证明了参数化依赖关系的保持。
VGGT-CAD
参数化CAD重建需要从视觉观测中同时恢复精确的几何形状和可编辑的建模操作,因此在视角有限且存在歧义的情况下具有挑战性。现有方法主要依赖2D外观线索,缺乏强大的多视图几何先验。在本工作中,我们提出了VGGT-CAD,一种用于从单视图和多视图观测进行参数化CAD重建的几何感知框架。我们通过将相机参数编码为条件token,并将其与图像token联合建模,将预训练的3D几何先验迁移到CAD重建中。为了处理数量可变的视角,我们引入了一个变视角跨视图上下文聚合模块,自适应地融合多视图特征。我们进一步提出了一种无需训练的几何感知视图选择策略,在推理过程中选择互补且可靠的帧。所得到的表示通过非自回归解码器解码为CAD命令序列。我们还开发了VideoCAD,一个通过多视图重渲染从现有CAD数据派生的大规模多视图视频基准。大量实验证明了VGGT-CAD在不同观测配置下进行视觉CAD重建的有效性。
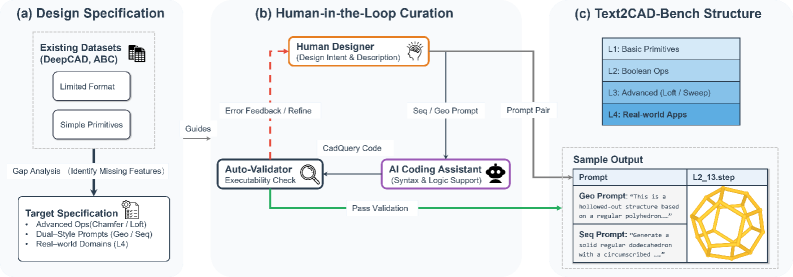
Text2CAD
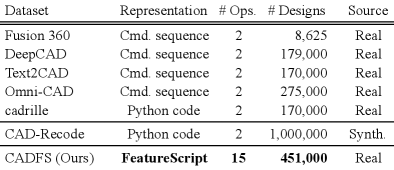
在现代软件中设计复杂的计算机辅助设计(CAD)原型非常耗时,这是由于缺乏能够快速生成较简单中间部件的智能系统。我们提出Text2CAD,这是首个利用面向所有技能水平的设计师友好型指令生成文本到参数化CAD模型的人工智能框架。此外,我们引入了一个数据标注流程,基于自然语言指令为DeepCAD数据集生成文本提示,使用了Mistral和LLaVA-NeXT。该数据集包含约17万个模型和约66万条文本注释,涵盖从抽象CAD描述(例如,生成两个同心圆柱体)到详细规格(例如,绘制两个圆心在(x,y)、半径分别为r1和r2的圆,并沿法线方向拉伸d...)。在Text2CAD框架内,我们提出了一种端到端的基于Transformer的自回归网络,用于从输入文本生成参数化CAD模型。我们通过一系列指标评估模型性能,包括视觉质量、参数精度和几何准确性。我们提出的框架在人工智能辅助设计应用中显示出巨大潜力。我们的源代码和注释将公开发布。
从二维正投影图纸自动重建三维CAD模型
两阶段方法利用模式匹配和环检测从二维正投影图纸重建三维CAD模型,F-score达99.59%
用于深度学习加工特征识别的三维CAD模型图表示
提出三维CAD模型图表示,用于深度学习加工特征识别,优于体素表示。
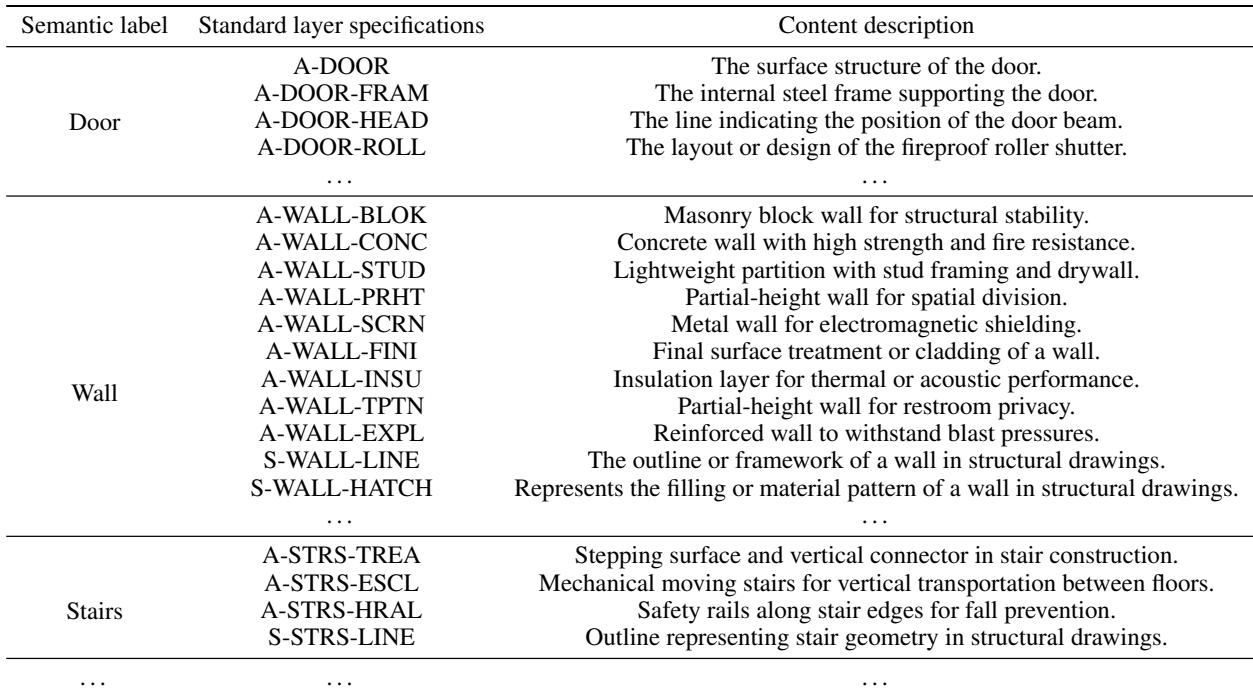
ArchCAD-400K
Derived from paper: ArchCAD-400K: An Open Large-Scale Architectural CAD Dataset and New Baseline for Panoptic Symbol Spotting
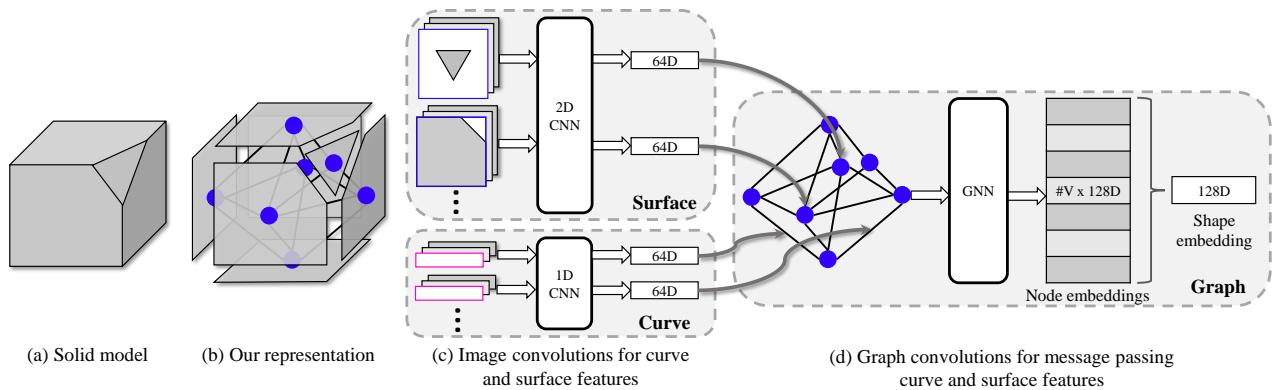
UV-Net
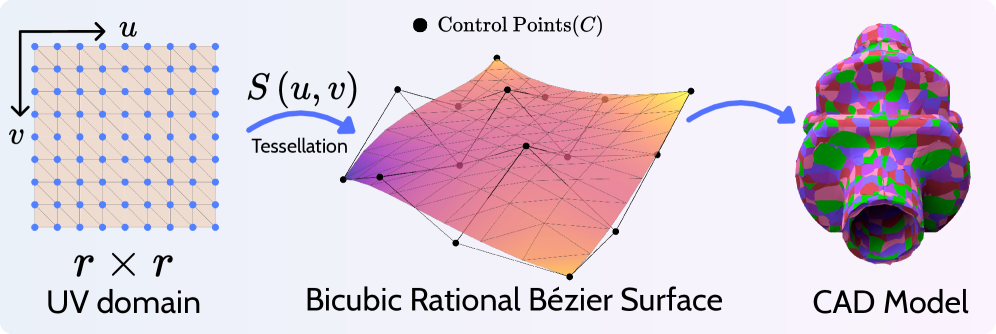
我们提出了UV-Net,一种新颖的神经网络架构和表示方法,旨在直接处理来自3D CAD模型的边界表示(B-rep)数据。B-rep格式广泛应用于设计、仿真和制造行业,以实现复杂而精确的CAD建模操作。然而,由于数据结构的复杂性及其对连续非欧几里得几何实体和离散拓扑实体的支持,B-rep数据在使用现代机器学习时面临一些独特挑战。在本文中,我们提出了一种统一的B-rep数据表示方法,该方法利用曲线和曲面的U和V参数域来建模几何,并利用邻接图显式建模拓扑。这产生了一种独特且高效的网络架构UV-Net,它以计算和内存高效的方式耦合了图像卷积神经网络和图卷积神经网络。为了辅助未来研究,我们提供了一个合成标注的B-rep数据集SolidLetters,该数据集源自人工设计的字体,并在几何和拓扑上具有变化。最后,我们证明UV-Net能够在五个数据集上泛化到监督和无监督任务,同时优于点云、体素和网格等替代3D形状表示。
Sketch-graphs
Derived from paper: Sketch-graphs: A large-scale dataset for modeling relational geometry in computer-aided design
MF-UAVPose6D
For uncrewed aerial vehicles (UAVs), estimating six-degree-of-freedom (6-DoF) poses is essential for airspace situational awareness, target tracking, and counter-UAV operations. However, non-cooperative targets usually lack computer-aided d...
CVRO